Start med én idé: En matrise er en maskin. Du sender inn en vektor x, og maskinen sender ut Ax. SVD endrer ikke maskinen; den åpner den og viser tre enkle handlinger på innsiden:
xV⊤finn hovedretningeneΣstrekk eller klemUAx.
Det er hele historien i miniatyr. Resten av SVD-delen forklarer hvordan vi finner disse retningene, hvor sterke de er, og hva vi kan bruke dem til. Hvis ordene rang, verdirom, radrom, kjerne og norm er litt rustne, åpner du oppfriskningen under.
Oppfriskning fra lineær algebra: fem begreper som henger sammen
Vi bruker én matrise til å koble sammen alle begrepene:
A=(100111)∈R2×3.
Formen 2×3 betyr at A tar inn en vektor med tre koordinater og gir ut en vektor med to koordinater:
A:R3⟶R2.
1. Rang — hvor mange uavhengige retninger har matrisen? Kolonnene er
c1=(10),c2=(01),c3=(11)=c1+c2.
Den tredje kolonnen er altså laget av de to første. Bare to kolonner gir nye retninger, så rank(A)=2.
2. Verdirom eller kolonnerom — hvilke svar kan komme ut? For x=(x1,x2,x3)⊤ er
Ax=x1c1+x2c2+x3c3.
Alle utvektorer er derfor lineærkombinasjoner av kolonnene. Det er grunnen til at verdirommet og kolonnerommet er samme rom:
range(A)=col(A)=span{c1,c2,c3}.
Her spenner c1 og c2 ut hele R2, så range(A)=R2. Helt konkret, velg
x=2−13.
Da får vi
Ax=(52),
Dermed ligger vektoren
(52)
i verdirommet. Verdirom betyr altså alle mulige svar Ax, ikke tallene som tilfeldigvis står i matrisen.
3. Radrom — hvilke inputretninger kan matrisen registrere? Radene er vektorer i inputrommet R3:
row(A)=span{(101),(011)}.
Radrommet og verdirommet ligger i forskjellige rom — henholdsvis R3 og R2 — men de har alltid samme dimensjon. Den dimensjonen er rangen, her 2.
4. Kjerne eller nullrom — hvilke input blir fullstendig visket ut? Vi løser Ax=0:
x1+x3=0,x2+x3=0.
Setter vi x3=t, får vi
x=t−1−11,ker(A)=span⎩⎨⎧−1−11⎭⎬⎫.
For eksempel, når
x=−1−11,
får vi Ax=0. Matrisen klarer ikke å skille denne retningen fra null.
5. Norm — hvor stor er en vektor eller matrise? For en vektor måler 2-normen vanlig euklidsk lengde:
3402=32+42+02=5.
For en matrise måler Frobenius-normen størrelsen på alle elementene samlet, så ∥A∥F=12+12+12+12=2. Operatornormen måler i stedet den største strekkfaktoren,
∥A∥2=∥x∥2=1max∥Ax∥2,
og senere ser vi at den er lik den største singulærverdien.
Koblingen du bør huske fra eksemplet er
rank(A)=dimrange(A)=dimrow(A)=2,
mens dimker(A)=1.
Rang–nullitet — regnskapet som alltid må gå opp. For enhver matrise
A∈Rm×n gjelder
rank(A)+dimker(A)=n.
Her er n antall inputkoordinater, altså antall kolonner i A. Hver
inputretning havner i én av to bunker: enten kan matrisen registrere den, og da
bidrar den til rangen, eller så viskes den ut, og da bidrar den til kjernen. I
eksemplet vårt er regnskapet
Dette er rang–nullitet i praksis. Husk at høyresiden er antall kolonner, ikke
antall rader.
Dette skal du kunne etter temaet
forklare hvorfor en matrise deles opp i enklere faktorer
lese dimensjonene i en full, redusert og kompakt SVD
regne ut en SVD for en liten matrise
tolke U, Σ og V⊤ geometrisk
lese rang, verdirom, kjerne og normer fra singulærverdiene
bygge og vurdere en trunkert SVD
regne ut en pseudoinvers og tolke minste-kvadraters løsninger
lese orden, fibrer og snitt og bygge rang-1-tensorer med ytre produkt
bruke vektorisering, matriseringsrekkefølgen i kurset og k-modusproduktet dimensjonssikkert
skille CP/ALS fra Tucker/HOSVD/HOOI og oppgi dimensjonene til alle faktorene
Del 1 · Matrisefaktorisering og egenverdidekomponering
Hvorfor faktoriserer vi en matrise?
Motivasjon
En matrisefaktorisering skriver én matrise som et produkt av enklere matriser.
For eksempel
A=BCeller mer genereltA=D1D2D3.
Poenget er ikke å skrive om A bare for moro skyld.
Vi velger faktorer som gjør A billigere å lagre, enklere å bruke eller lettere å forstå.
Når A=BC virker på en vektor, virker faktoren lengst til høyre først:
x⟼Cx⟼B(Cx)=Ax.
Oppfriskning: reglene for matrisemultiplikasjon
Hvis B∈Rm×k og C∈Rk×n, må de indre dimensjonene være like, og
BC∈Rm×n.
Oppføring (i,j) er indreproduktet av rad i i B og kolonne j i C:
(BC)ij=ℓ=1∑kbiℓcℓj.
For eksempel
(102−1)(34)=(1⋅3+2⋅40⋅3−1⋅4)=(11−4).
Med flere faktorer kontrollerer du hvert nabopar og husker at faktoren lengst til høyre virker først.
Se dette i praksis
Gjennomregnet minieksempel 1. La
A=(2003).
Å skrive A=IA er riktig, men avslører ingenting. En form med tre faktorer er
A=(1001)(2003)(1001).
Den midterste faktoren strekker første koordinat med 2 og andre koordinat med 3.
Identitetsmatrisene endrer ingenting.
Det nyttige er altså ikke bare at uttrykket er et produkt. Faktorene forteller hva operasjonen gjør.
Hurtigsjekk 1. La D=diag(4,1). Skriv D som tre faktorer med identitetsmatriser ytterst. Hva gjør den midterste faktoren med (x1,x2)⊤?
Løsning
Steg 1:
D=I2(4001)I2.
Steg 2: Identiteten til høyre lar inputen være uendret, den midterste matrisen sender (x1,x2)⊤ til (4x1,x2)⊤, og identiteten til venstre endrer igjen ingenting. Første koordinat strekkes altså med 4, mens den andre er uendret.
Lavrang-idé for lagring
Før du sovner, la meg forklare dette kjapt. Lav rang betyr at en stor matrise kan bygges opp fra noen få viktige retninger, så vi lagrer disse retningene i stedet for hver eneste oppføring.
Anta at A∈Rn×n er enorm. Hvis den kan representeres nøyaktig eller omtrent som
A≈BC,B∈Rn×k,C∈Rk×n,k≪n,
er B høy og C bred.
Produktet BC har fortsatt størrelse n×n.
En full matrise lagrer n2 tall, mens faktorene lagrer
nk+kn=2nk
tall.
Direkte bruk av A krever omtrent n2 operasjoner.
Faktorformen B(Cx) krever omtrent 2nk.
Se dette i praksis
Gjennomregnet minieksempel 2. La n=1000 og k=5. En full 1000×1000-matrise lagrer
10002=1000000
tall. Faktorene B∈R1000×5 og C∈R5×1000 lagrer
1000⋅5+5⋅1000=10000
tall. Faktorformen bruker derfor 1/100 så mange tall—en komprimering med faktor 100.
Hurtigsjekk 2. En 2400×2400-matrise tilnærmes med BC med indre dimensjon k=12. Finn dimensjonene til B,C, sammenlign n2 med 2nk, og oppgi komprimeringsfaktoren.
Løsning
Steg 1:B må være 2400×12, og C må være 12×2400.
Steg 2: Den fulle matrisen lagrer
24002=5760000
tall, mens faktorene lagrer
2⋅2400⋅12=57600.
Steg 3: Siden 5760000/57600=100, bruker faktorformen 1/100 så mange tall—en komprimering med faktor 100.
Egenverdidekomponering som utgangspunkt
Påminnelse: egenverdier og egenvektorer
En egenverdi λ til en kvadratisk matrise A og en tilhørende egenvektor v=0 oppfyller
Av=λv.
Slik finner vi egenparene:
Løs den karakteristiske ligningen det(A−λI)=0.
For hver egenverdi λi, løs (A−λiI)vi=0.
Normaliser egenvektorene når vi trenger en ortonormal basis.
Se dette i praksis
Gjennomregnet minieksempel 3. For
A=(2005)
har vi
A(10)=2(10),A(01)=5(01).
Koordinataksene er altså egenvektorretninger med egenverdier 2 og 5.
Hurtigsjekk 3. Finn egenparene til D=diag(4,−2), og forklar den negative egenverdien geometrisk.
Løsning
Steg 1:De1=4e1, så (4,e1) er ett egenpar.
Steg 2:De2=−2e2, så (−2,e2) er det andre egenparet.
Steg 3: Tallet −2 betyr at e2-retningen strekkes med 2 og snus.
Eksempel: diagonaliserbar matrise
Eksemplet fra forelesningsnotatene er
A=41(5−3−35).
Enhetsegenvektorene og egenverdiene er
v1=21(1−1),λ1=2,v2=21(11),λ2=21.
Dermed er
A=VΛV⊤,V=(v1v2),Λ=diag(2,21).
Rekkefølgen betyr noe: Hver diagonalverdi i Λ må stå ved kolonnen i V som tilhører samme egenpar.
Geometrisk betydning
Fordi dette eksemplet er symmetrisk, gir de ortonormale egenvektorene hovedaksene til bildet av enhetssirkelen. v1-retningen strekkes med 2, mens v2-retningen forkortes med 1/2.
Se dette i praksis
Gjennomregnet minieksempel 4. For
D=(3001)
blir enhetsvektorene e1 og e2 sendt til 3e1 og e2. Enhetssirkelen blir derfor en ellipse med vannrett halvakse 3 og loddrett halvakse 1.
Hurtigsjekk 4. Beskriv bildet av enhetssirkelen under D=diag(4,2). Hva er hovedretningene og halvaksenes lengder?
Løsning
Steg 1:De1=4e1 og De2=2e2.
Steg 2: Hovedretningene er dermed koordinataksene.
Steg 3: Bildet er en ellipse med halvakser 4 og 2.
Appendiks: egenverdiberegning og to snarveier i nullrommet
For forelesningsmatrisen er
det(A−λI)=(45−λ)2−169=λ2−25λ+1.
Røttene er λ=1/2 og λ=2.
Hvorfor egenverdier ikke er nok
Begrensninger ved egenverdidekomponering
Det reelle geometriske egenverdibildet fungerer ryddig bare når A har en nyttig reell egenbasis.
Tre problemer dukker opp:
Rektangulære matriser har ingen vanlig egenverdidekomponering.
Defekte matriser har for få egenvektorer.
Reelle rotasjoner kan ha bare komplekse egenverdier.
Se dette i praksis
Gjennomregnet minieksempel 5. Matrisen
R=(01−10)
roterer alle vektorer 90∘. Spesielt er Re1=e2, som ikke er parallell med e1. Det karakteristiske polynomet er λ2+1, så det finnes ingen reelle egenverdier eller reelle egenvektorretninger. SVD gir likevel reelle, ikke-negative singulærverdier.
Hurtigsjekk 5. La S=(0−110). Vis at den roterer −90∘ og ikke har reelle egenverdier.
Løsning
Steg 1:
Se1=(0−1)=−e2,
så den positive vannrette retningen roteres 90∘ med klokken.
Steg 2:
det(S−λI)=det(−λ−11−λ)=λ2+1.
Steg 3: Røttene er ±i, så det finnes ingen reelle egenverdier.
Eksempel: ikke-diagonaliserbar matrise
For
A=(10c1),c=0,
er den eneste egenverdien 1, med algebraisk multiplisitet 2. Men
(A−I)v=0⟹cv2=0,
så hver egenvektor er et multiplum av
(10).
Den geometriske multiplisiteten er bare 1.
Derfor kan A ikke diagonaliseres. Det er nettopp for slike matriser at SVD er mer robust.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 2 · Singulærverdidekomponering
Ortogonale matriser
En kvadratisk matrise Q=(q1⋯qn) er ortogonal når
Q⊤Q=I.
Dette er ekvivalent med at kolonnene er ortonormale:
qi⊤qj={1,0,i=j,i=j.
Ekvivalensen kan leses oppføring for oppføring. Hvis en rektangulær SVD-faktor skrives Ur=(u1⋯ur), er
(Ur⊤Ur)ij=ui⊤uj=δij.
Likheten Ur⊤Ur=Ir sier at kolonnene har norm 1 og står vinkelrett på hverandre.
Ikke snu utsagnet blindt.
UrUr⊤ er bare identitetsmatrisen når Ur er kvadratisk og ortogonal.
Kontroller ortonormale kolonner på forelesningsmatrisen på 3 ganger 2
For matrisen som brukes igjen i transponeringseksemplet,
A2=21112−1,
er de reduserte venstre singulærvektorene
u1=21110,u2=611−12.
Lengdekvadratene er
∥u1∥22=21+1=1,∥u2∥22=61+1+4=1,
og indreproduktet er
u1⊤u2=121−121+0=0.
Dermed har Ur=(u1u2) egenskapen Ur⊤Ur=I2. Den er fortsatt en 3×2-matrise, ikke en ortogonal matrise i kvadratisk forstand, og
UrUr⊤=Prange(A2)=I3.
Den reduserte faktoren er nok for eksakt rekonstruksjon og pseudoinversen. Fullfør den med en tredje ortonormal vektor bare når du trenger en basis for hele R3 eller for ker(A2⊤).
Se dette i praksis
Gjennomregnet minieksempel 6. La
Q=(01−10).
Kolonnene er
q1=(01),q2=(−10).
Begge har lengde 1, og q1⊤q2=0.
Dermed er Q⊤Q=I.
For
x=(34)
får vi
Qx=(−43).
Både x og Qx har lengde 5. Rotasjonen bevarer altså lengde.
Hurtigsjekk 6. Kontroller at Q=51(34−43) er ortogonal, og vis direkte at den bevarer normen til
x=(50).
Løsning
Steg 1: Hver kolonne har lengdekvadrat (32+42)/25=1, og indreproduktet mellom dem er (3(−4)+4(3))/25=0.
Steg 2: Derfor er Q⊤Q=I.
Steg 3:
Qx=(34),∥Qx∥2=5=∥x∥2.
SVD-setningen
Les produktet fra høyre mot venstre:
V⊤ uttrykker inputen i ortonormale inputretninger.
Σ strekker eller kollapser koordinatene.
U plasserer resultatet i ortonormale outputretninger.
Se dette i praksis
Gjennomregnet minieksempel 7. Den positive diagonalmatrisen
A=(3001)
viser allerede SVD-en sin:
U=I,Σ=diag(3,1),V=I.
Dermed er σ1=3 og σ2=1.
Hurtigsjekk 7. Oppgi en SVD av D=diag(4,2) og finn singulærverdiene.
Løsning
Fasit:
D=I(4002)I⊤.
Dermed er σ1=4 og σ2=2.
Forklaring: Diagonalverdiene er allerede ikke-negative og sortert avtakende, så vi trenger ingen retningsendring.
Formen til Σ
Σ har alltid samme form som A.
Hvis m≤n, har den høyst m ikke-null diagonalverdier og ekstra nullkolonner.
Hvis m≥n, har den høyst n ikke-null diagonalverdier og ekstra nullrader.
Se dette i praksis
Gjennomregnet minieksempel 8. Hvis A∈R3×2, er
Σ=σ1000σ20.
Hvis A∈R2×3 i stedet, er
Σ=(σ100σ200).
Hurtigsjekk 8. Skriv den generelle formen til Σ for A∈R4×2 og for B∈R2×5.
Løsning
Fasit: For A er
ΣA=σ10000σ200.
For B er
ΣB=(τ100τ2000000).
Begge har nøyaktig samme dimensjoner som den opprinnelige matrisen.
Forklaring: I full SVD har Σ alltid samme rektangulære form som den opprinnelige matrisen. Bare diagonalposisjonene kan være ulike null.
Bevisidé: hvorfor finnes SVD?
For A=0 velger vi en enhetsvektor v1 der ∥Av∥2 er størst, og setter
σ1=∥Av1∥2,u1=σ1Av1.
Fullfør v1 og u1 til ortonormale basiser.
I disse basisene skiller maksimaliteten det første strekket fra en mindre restblokk.
Gjenta på restblokken. Slik bygges alle singulærretningene.
Dette er et eksistensargument, ikke eksamensmetoden. I beregninger bruker vi A⊤A eller AA⊤.
Hvis A=0, velger vi Σ=0 og vilkårlige ortogonale U og V; da er A=UΣV⊤ med én gang.
Se dette i praksis
Gjennomregnet minieksempel 9. For A=diag(3,1) oppnås maksimum av ∥Ax∥2 over enhetsvektorene ved v1=e1, fordi Av1=3e1. Dermed er σ1=3 og u1=e1. I den gjenværende vinkelrette retningen e2 er strekket 1, så σ2=1.
Hurtigsjekk 9. Bruk den samme største-strekk-ideen på D=diag(5,2). Finn v1,u1,σ1 og den gjenværende singulærtrippelen.
Løsning
Fasit:v1=u1=e1, σ1=5, og den gjenværende trippelen er v2=u2=e2, σ2=2.
Forklaring:De1=5e1 er det største strekket. I den vinkelrette retningen er De2=2e2.
Full, redusert/økonomi og kompakt SVD
Jeg vet at dette ser helt jævlig ut, men la meg bryte det ned. Dette er ikke tre ulike dekomponeringer; det er de samme singulærretningene med ulik mengde bokføring av nullretninger.
La A∈Rm×n og q=min(m,n). Tre nært beslektede konvensjoner er vanlige:
Full SVD:
A=UΣV⊤,U:m×m,Σ:m×n,V:n×n.
Begge ytterfaktorene er kvadratiske ortogonale matriser:
U⊤U=UU⊤=Im,V⊤V=VV⊤=In.
Redusert, tynn eller økonomi-SVD:
A=UqΣqVq⊤,Uq:m×q,Σq:q×q,Vq:n×q.
Denne bygger fortsatt opp A nøyaktig, også når noen av de q singulærverdiene er null.
Kolonnene er ortonormale:
Uq⊤Uq=Vq⊤Vq=Iq.
En rektangulær Uq eller Vq er ikke en ortogonal matrise i den kvadratiske, fulle betydningen. Produktene i motsatt rekkefølge trenger ikke å være identitetsmatriser.
Det er nyttig å skrive økonomidimensjonene separat for høye og brede matriser:
Form på A
Økonomifaktorisering
Faktordimensjoner
Høy, m≥n og q=n
A=UqΣqV⊤
Uq:m×n, Σq:n×n, V:n×n
Bred, n≥m og q=m
A=UΣqVq⊤
U:m×m, Σq:m×m, Vq:n×m
I det høye tilfellet er høyrefaktoren allerede kvadratisk; i det brede tilfellet er venstrefaktoren allerede kvadratisk. Dette er den dimensjonssikre økonomikonvensjonen.
Kompakt eller rang-r-SVD: Hvis r=rank(A) er antallet positive singulærverdier, med r=0 for nullmatrisen, forkaster vi alle null-singulærretningene:
A=UrΣrVr⊤,Ur:m×r,Σr:r×r,Vr:n×r.
Her er
UrUr⊤=Prange(A),VrVr⊤=Pker(A)⊥.
Disse projektoridentitetene gjelder de kompakte faktorene med positive singulærverdier.
Ikke bruk dem om en økonomifaktor som er fylt ut med vilkårlige null-singulærretninger. Når A har full rang, er r=q, og den kompakte formen er lik økonomiformen.
Økonomiformen foretrekkes vanligvis i beregninger og lagring.
Den bygger opp A nøyaktig uten ubrukte basisvektorer.
Den kompakte formen er enda mindre når A er rangdefekt. Den beholder akkurat de positive singulærretningene vi trenger for rekonstruksjon, pseudoinversen, verdirommet og ker(A)⊥.
Bruk full form når du trenger komplette ortonormale basiser for Rm og Rn. Det inkluderer alle retninger i ker(A⊤) eller ker(A).
Slik går du mellom formene:
Finn de positive singulærtriplene. De gir kompakt SVD.
Legg til ortonormale null-singulærretninger til hver tynn faktor har q kolonner. Da får du økonomi-SVD.
Fullfør begge sider til fulle ortonormale basiser, og fyll Σ med nullrader eller nullkolonner. Da får du full SVD.
For en høy matrise legger full form hovedsakelig kolonner til Uq og nullrader til Σ.
For en bred matrise legger full form hovedsakelig kolonner til Vq og nullkolonner til Σ.
Full kontra redusert SVD på den håndregnede matrisen
Den korrigerte forelesningsmatrisen som brukes i hovedeksemplet nedenfor, er
A=123321∈R3×2.
Her er q=r=2, så økonomi-SVD og kompakt SVD er samme form:
Den ekstra basisretningen bidrar ikke fordi den kobles til en nullrad:
UΣV⊤=UrΣrVr⊤+0u3(00)V⊤=A.
Den reduserte formen bygger altså opp A nøyaktig.
Den er nok for singulærverdiene, V, Σr og
A†=VrΣr−1Ur⊤.
Den fulle formen legger bare til u3 når vi ønsker en komplett basis for R3, en eksplisitt basis for ker(A⊤) eller den komplementære projeksjonen
u3u3⊤=I3−UrUr⊤.
Se dette i praksis
Gjennomregnet minieksempel 10. Hvis A∈R100×3 har full kolonnerang, bruker full SVD en 100×100-matrise U, men bare tre kolonner kan bidra. Den reduserte formen bruker
Ur:100×3,Σr:3×3,Vr⊤:3×3.
Hurtigsjekk 10. Oppgi dimensjonene i redusert SVD for en fullrang 8×3-matrise og en fullrang 3×8-matrise.
Løsning
Fasit: For 8×3 er
Ur:8×3,Σr:3×3,Vr⊤:3×3.
For 3×8 er
Ur:3×3,Σr:3×3,Vr⊤:3×8.
Forklaring: Redusert/økonomi-SVD bruker q=min(m,n)=3 singulærretninger i begge tilfeller. Den rektangulære faktoren står på den største siden.
Transponering og symmetriske matriser
Transponeringsegenskapen
Før vi transponerer en hel SVD, tar vi den mekaniske regelen én gang:
Oppfriskning: transponer en 2 × 2-matrise
Å transponere betyr at kolonnene blir rader. For en generell
2×2-matrise er regelen
(acbd)⊤=(abcd).
Diagonaloppføringene a og d blir stående. De to oppføringene utenfor
diagonalen, b og c, bytter plass. For eksempel:
A=(1−243)⟹A⊤=(14−23).
En rask kontroll er at en ny transponering skal gi originalen tilbake:
(A⊤)⊤=A.
Transponering av A=UΣV⊤ gir
A⊤=VΣ⊤U⊤.
De venstre og høyre singulærretningene bytter roller.
Strekkstørrelsene endres ikke.
Derfor har A og A⊤ de samme singulærverdiene, og
∥A∥2=∥A⊤∥2.
På én linje: Hvis full SVD er A=UΣV⊤, får vi full SVD av den transponerte matrisen ved å bytte venstre og høyre rolle og transponere den rektangulære midtfaktoren:
U=V,Σ=Σ⊤,V=U.
For en redusert SVD gir samme snarvei
A⊤=VrΣrUr⊤,
fordi Σr er diagonal. Spesielt er Vr=Ur.
Hele transponeringssnarveien på en konkret $3\times2$-matrise
La
A2=21112−1∈R3×2.
Den minste Gram-matrisen er
A2⊤A2=(6336).
Egenverdiene er 9 og 3, så singulærverdiene er 3 og 3. De tilhørende normaliserte egenvektorene gir
V=21(111−1).
Formelen ui=A2vi/σi gir
u1=21110,u2=611−12,Ur=(u1u2)∈R3×2.
En siste enhetsvektor,
u3=31−111,
oppfyller A2⊤u3=0. En full venstrefaktor og den fulle rektangulære diagonalfaktoren er derfor
Definer nå A3=A2⊤∈R2×3. Uten noen ny utregning får vi
A3=A2⊤=VΣ⊤U⊤=UΣV⊤,
der de viste fulle faktorene er
U=V=21(111−1),Σ=Σ⊤=(300300),V=U.
De fulle dimensjonene for A3 er altså (2×2)(2×3)(3×3). I redusert form er
A3=VΣrUr⊤,Ur=V:2×2,Σr=Σr:2×2,Vr=Ur:3×2.
Full U,V,U,V er kvadratiske ortogonale matriser.
Den rektangulære Ur=Vr har i stedet ortonormale kolonner:
Ur⊤Ur=I2.
Den er ikke en kvadratisk ortogonal matrise.
Transponering bytter bare hvilke singulærvektorer som beskriver input- og outputrommet.
Til slutt har
A2A2⊤=54145−11−12
egenverdiene 9,3,0, mens A2⊤A2 har egenverdiene 9,3.
Egenverdiene som ikke er null, er de samme.
Den ekstra nullen hører til u3∈ker(A2⊤). Etter transponering er dette den ekstra høyre nullromsretningen til A3.
Nettopp derfor har den fulle 3×3-faktoren én kolonne mer enn den reduserte faktoren.
Se dette i praksis
Gjennomregnet minieksempel 11. For A=diag(3,1) er A⊤=A, så begge har singulærverdier 3,1. For den ikke-kvadratiske radmatrisen B=(12) er
B⊤=(12),∥B∥2=∥B⊤∥2=12+22=5.
Hurtigsjekk 11. Finn den eneste positive singulærverdien til C=(2−2) og til C⊤.
Løsning
Fasit:
CC⊤=22+(−2)2=8.
Den positive singulærverdien er derfor 8=22. Transponering endrer den ikke.
Forklaring: En matrise med én rad har én positiv singulærverdi lik den euklidske lengden til raden, og C og C⊤ deler denne verdien.
Sammenhengen med A⊤A og AA⊤
Her hoper symbolene seg opp, men grepet er enkelt: Sett inn SVD-en, forkort en ortogonal faktor og les av diagonalverdiene i andre.
Start dimensjonssikkert fra den fulle SVD-en A=UΣV⊤, der U:m×m, Σ:m×n og V:n×n. Da er
A⊤A=(UΣV⊤)⊤(UΣV⊤)=VΣ⊤ImU⊤UΣV⊤=V(Σ⊤Σ)V⊤,
og tilsvarende
AA⊤=(UΣV⊤)(UΣV⊤)⊤=UΣInV⊤VΣ⊤U⊤=U(ΣΣ⊤)U⊤.
Diagonalmatrisene Σ⊤Σ og ΣΣ⊤ inneholder de samme positive tallene σi2.
De skiller seg bare i antallet nuller.
I kompakt form er den ikke-null diagonale blokken Σr2.
Fordi V⊤vi=ei og U⊤ui=ei, gir multiplikasjon av de to dekomponeringene med én faktorkolonne
A⊤Avi=σi2vi,AA⊤ui=σi2ui.
Kolonnene i V er altså egenvektorer til A⊤A.
Kolonnene i U er egenvektorer til AA⊤.
De positive singulærverdiene er kvadratrøttene av de positive egenverdiene. For σi>0 er
ui=σiAvi,vi=σiA⊤ui.
Begge Gram-matrisene er positivt semidefinite. For hver kompatibel vektor x er nemlig
x⊤A⊤Ax=(Ax)⊤(Ax)=∥Ax∥22≥0.
Derfor er egenverdiene reelle og ikke-negative, og hver singulærverdi σi=λi er reell og ikke-negativ.
Sammenlign begge Gram-matrisene på forelesningsmatrisen på 3 ganger 2
For
A2=21112−1
er den minste Gram-matrisen
A2⊤A2=(6336),
med egenverdier 9 og 3. Den større Gram-matrisen er
A2A2⊤=54145−11−12,
med egenverdier 9,3,0. Dermed er
spec(A2⊤A2)={9,3},spec(A2A2⊤)={9,3,0}.
Den ekstra nullverdien svarer til den manglende outputretningen u3∈ker(A2⊤).
Begge matrisene gir singulærverdiene 3 og 3.
Velg den minste Gram-matrisen for å spare regning. Velg A⊤A når du vil finne vi direkte, og AA⊤ når du vil finne ui direkte.
Eksamenfelle: når begge Gram-matrisene er 2 × 2
For en 2×2-matrise er både A⊤A og AA⊤ av størrelse
2×2. Det finnes derfor ingen størrelsesgevinst. Valget bestemmer bare
hvilke singulærvektorer du får direkte:
A⊤A=VΣ2V⊤⟹egenvektorene er vi,AA⊤=UΣ2U⊤⟹egenvektorene er ui.
Singulærverdiene blir de samme. Velg én av Gram-matrisene, og koble deretter
sammen venstre og høyre side med
ui=σiAviellervi=σiA⊤ui,σi>0.
Fellen er å diagonalisere begge Gram-matrisene hver for seg. Egenvektorer
kan skifte fortegn. Ved gjentatte egenverdier kan du til og med velge ulike
ortonormale basiser i samme egenrom. Da kan hver liste være riktig alene uten
at ui og vi er paret riktig, og rekonstruksjonen kan bli feil.
Ta
A=(200−3).
Her er
A⊤A=AA⊤=(4009).
Med avtakende rekkefølge kan vi velge
V=(e2e1)=(0110),Σ=diag(3,2).
Hvis vi bare kopierer og setter U=V, får vi
UΣV⊤=(2003)=A;
minusfortegnet har forsvunnet. Formelen reparerer paret:
u1=3Ae2=−e2,u2=2Ae1=e1.
Dermed er
U=(−e2e1)=(0−110),UΣV⊤=A.
Praktisk eksamensregel. Bruk A⊤A når oppgaven eller notatene ber om
V, og lag så hvert ui med Avi/σi. Ikke finn begge sider uavhengig.
Hvis σi=0, kan du ikke dele. I en full SVD fullfører du da U med en
enhetsvektor som er ortogonal på de venstre singulærvektorene du allerede har;
den ligger i ker(A⊤). Det er samme idé som den ekstra u3-retningen i
den fulle SVD-en av en høy matrise.
Se dette i praksis
Gjennomregnet minieksempel 12. La
A=300020.
Da er
A⊤A=(9004).
Egenverdiene er 9 og 4, så singulærverdiene til A er 3 og 2.
Hurtigsjekk 12. Bruk A⊤A til å finne singulærverdiene til A=400010.
Løsning
Fasit:
A⊤A=(16001).
Dermed er σ1=4 og σ2=1.
Forklaring: Gram-egenverdiene er 16 og 1, og singulærverdiene er de ikke-negative kvadratrøttene.
Symmetriske matriser
Hvis A=A⊤ har egenverdidekomponeringen A=QΛQ⊤, er
A⊤A=QΛ2Q⊤.
Singulærverdiene er derfor absoluttverdiene av egenverdiene, sortert avtakende:
σi=∣λi∣.
Se dette i praksis
Gjennomregnet minieksempel 13. Først: For A=diag(−3,2) er egenverdiene −3,2, mens singulærverdiene er 3,2. SVD husker størrelsen på hvert strekk; fortegnet tas opp i U eller V.
Se så på den symmetriske rang-1-matrisen
B=(1224)=(12)(12)=zz⊤,z=(12).
Den er åpenbart symmetrisk. Dessuten er
tr(B)=5>0,det(B)=4−4=0.
Dermed er B PSD, men ikke positiv definit. Determinanten er null og den andre kolonnen er dobbelt så stor som den første, så rangen er 1. Siden B=zz⊤, er
λ1=σ1=∥z∥22=5,q1=∥z∥2z=51(12).
Velg den vinkelrette enhetsvektoren
q2=51(−21),Q=(q1q2).
Fordi B er PSD, er egenverdidekomponeringen allerede en SVD:
B=Q(5000)Q⊤,U=V=Q.
Den kompakte rang-1-SVD-en er enda kortere:
B=5q1q1⊤.
Kjennetegn: Symmetri pluss at én ikke-null rad eller kolonne er et multiplum av den andre, skriker «rang-1 PSD». Hvis du kan skrive matrisen som zz⊤, hopper du over begge Gram-matrisene.
Hurtigsjekk 13.
a) Finn singulærverdiene til D=diag(−5,−1) og oppgi én gyldig SVD.
b) Vis at
E=(4−2−21)
er symmetrisk PSD av rang 1, og oppgi både kompakt og full SVD.
Løsning
Steg 1: løs del a. Singulærverdiene er 5 og 1. Ett gyldig valg er
U=(−100−1),Σ=(5001),V=I,
fordi UΣV⊤=D.
Steg 2: se rang-1-PSD-strukturen i del b. Skriv
E=(2−1)(2−1)=ww⊤,w=(2−1).
Dermed er E symmetrisk PSD. Kolonnene er avhengige, så rangen er 1. Det samme ser vi fra tr(E)=5>0 og det(E)=4−4=0.
Steg 3: les av den kompakte SVD-en. Siden ∥w∥22=5, er
q1=51(2−1),E=5q1q1⊤.
Dermed har den kompakte SVD-en Ur=Vr=q1 og Σr=(5).
Steg 4: fullfør en ortonormal basis for full SVD. Velg
q2=51(12),Q=51(2−112).
Da er q1⊤q2=0 og
E=Q(5000)Q⊤.
Én full SVD er derfor U=V=Q og Σ=diag(5,0).
Oppskrift for håndregning
Slik regner du ut en liten SVD analytisk:
Skriv dimensjonene.
Bygg den minste av A⊤A og AA⊤.
Finn de ikke-negative egenverdiene.
Ta kvadratrøttene og sorter avtakende.
Normaliser de tilhørende egenvektorene.
Bruk ui=Avi/σi eller vi=A⊤ui/σi.
Hold hver singulærtrippel i samme rekkefølge.
Multipliser tilbake og kontroller A=UrΣrVr⊤.
Se dette i praksis
Gjennomregnet minieksempel 14. For
A=100020∈R3×2
er A⊤A bare 2×2, mens AA⊤ er 3×3. Vi velger
A⊤A=diag(1,4),
så singulærverdiene er 2,1 etter sortering.
Hurtigsjekk 14. For A=20000300, finn den minste Gram-matrisen og singulærverdiene.
Løsning
Fasit:A⊤A er den minste Gram-matrisen, og singulærverdiene er 3 og 2.
Forklaring:A er 4×2, så A⊤A er bare 2×2:
A⊤A=diag(4,9).
Egenverdiene er 9,4 etter sortering. Kvadratrøttene er 3,2.
SVD finnes selv når diagonalisering feiler
En skjærmatrise kan ha for få lineært uavhengige egenvektorer til å kunne diagonaliseres. SVD har ikke denne begrensningen: Den bruker én ortonormal basis i inputrommet og en annen i outputrommet. Åpne utregningen nedenfor når du vil se hele algebraen.
Full utregning: SVD av en skjærmatrise som ikke kan diagonaliseres
For skjærmatrisen fra forelesningen,
A=(10c1),c=0,
er
AA⊤=(1+c2cc1).
Egenverdiene er
λ1,2=1+2c2±c2+4c4,
så singulærverdiene er kvadratrøttene. For c=8/3 forenkles de til 3 og 1/3, og én SVD er
U=101(31−13),Σ=(3001/3),V=101(13−31).
Matrisen kan ikke diagonaliseres, men SVD skiller den likevel i ortogonale retningsendringer og ikke-negative strekk.
Hovedeksempel: en komplett håndregnet redusert SVD
Dette er hele håndregningsoppskriften på den korrigerte forelesningsmatrisen. De åtte stegene er foldet sammen slik at hovedsiden forblir lett å skumme; åpne dem når du vil se hver multiplikasjon og dimensjonskontroll.
Full utregning: en redusert SVD fra start til slutt
Bruk den korrigerte forelesningsmatrisen
A=123321.
Steg 1: les dimensjonene og velg den minste Gram-matrisen.A er 3×2, så de reduserte faktorene må ha dimensjoner Ur:3×2, Σr:2×2 og Vr⊤:2×2. Den minste Gram-matrisen er A⊤A.
Steg 2: bygg A⊤A element for element. Kolonnene er
a1=123,a2=321.
Indreproduktene er
a1⊤a1=1+4+9=14,a2⊤a2=9+4+1=14,
og
a1⊤a2=3+4+3=10.
Dermed er
A⊤A=(14101014).
Steg 3: finn egenverdiene.
det(A⊤A−λI)=(14−λ)2−100=λ2−28λ+96=(λ−24)(λ−4).
Altså er λ1=24 og λ2=4.
Steg 4: ta kvadratrøtter, ikke bruk egenverdiene direkte.
σ1=24=26,σ2=4=2.
Steg 5: finn og normaliser de høyre singulærvektorene. For λ1=24 er kolonnene i A⊤A−24I motsatte. Derfor ligger
(11)
i nullrommet.
For λ2=4 er kolonnene identiske. Derfor ligger
(1−1)
i nullrommet. Etter normalisering:
v1=21(11),v2=21(1−1).
Steg 6: finn de venstre singulærvektorene. Bruk ui=Avi/σi:
Av1=21444⟹u1=31111,
og
Av2=21−202⟹u2=21−101.
Steg 7: sett sammen tilhørende kolonner i samme rekkefølge.
Steg 8: multipliser tilbake via rang-1-summen. Det første leddet er
σ1u1v1⊤=222222,
og det andre er
σ2u2v2⊤=−10110−1.
Summen er nøyaktig
222222+−10110−1=123321=A.
Uavhengig Axia-kontroll. Behold også den eksisterende matrisen
A=201021
for å vise at oppskriften ikke er knyttet til forelesningstallene. Her er
A⊤A=(5115),
så egenverdiene er 6,4 og singulærverdiene er 6,2.
De høyre singulærvektorene er
v1=21(11),v2=21(1−1).
De venstre singulærvektorene er
u1=31111,u2=211−10.
De to rang-1-leddene bygger matrisen nøyaktig:
A=111111+1−10−110.
Også denne multiplikasjonen gir nøyaktig den opprinnelige matrisen.
Laster interaktiv modell / Loading interactive model …
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 3 · Geometri, matriseegenskaper og beste lavrang-approksimasjon
Geometrien: V⊤, så Σ, så U
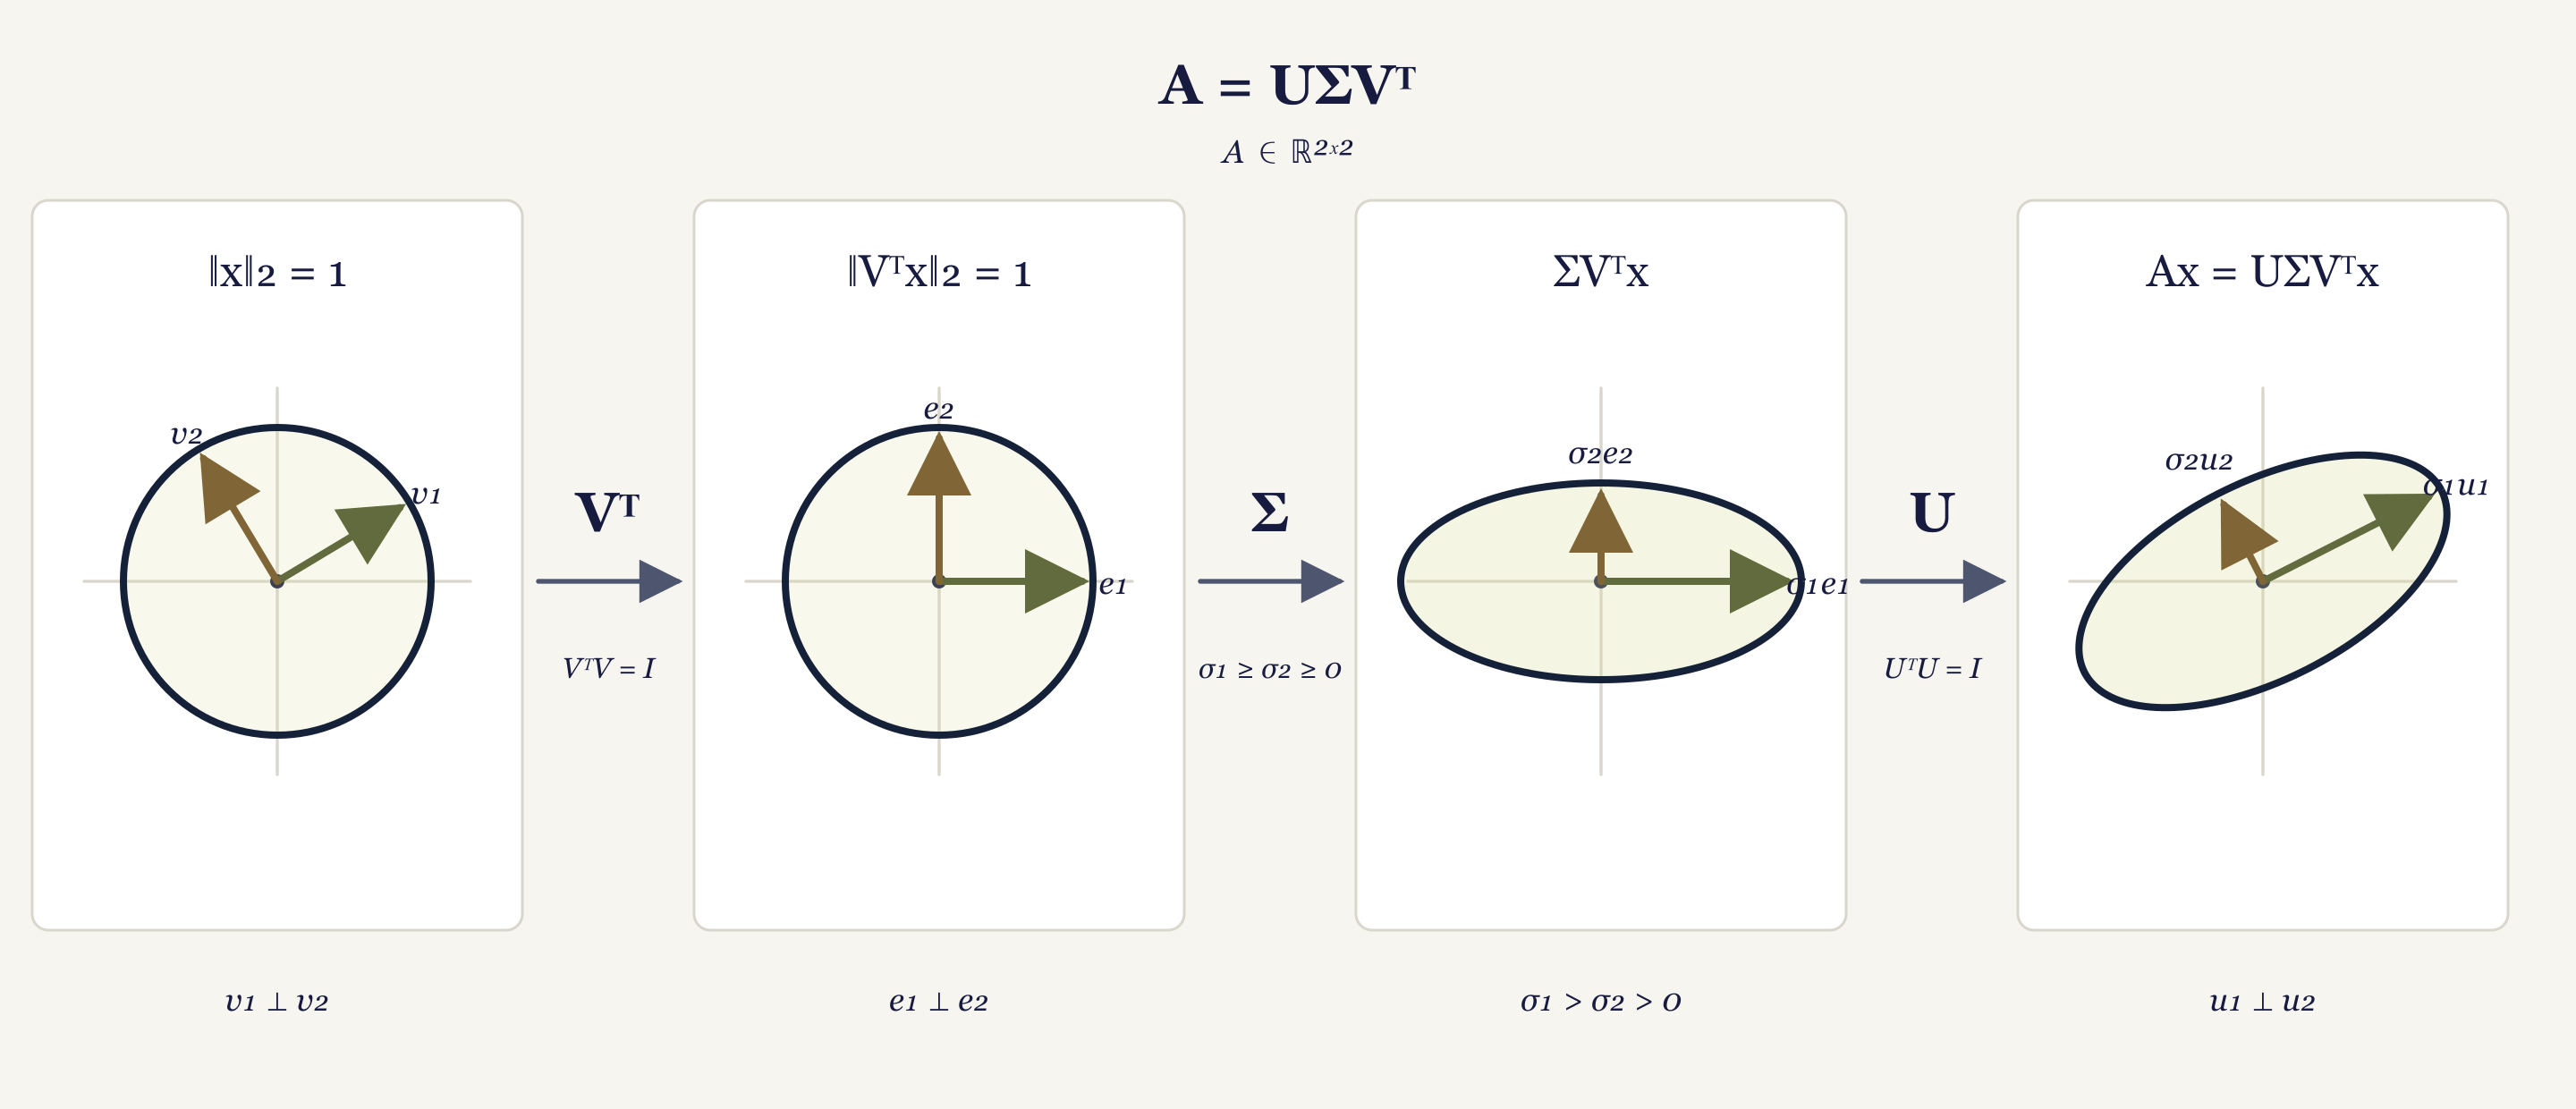
SVD sender enhetssirkelen gjennom en ortogonal retningsendring, aksevis skalering og en siste ortogonal retningsendring. Resultatet er en ellipse med halvakser lik singulærverdiene.Full størrelse / Full size ↗
Se dette i praksis
Gjennomregnet minieksempel 15. For A=diag(2,1) er
Ae1=2e1,Ae2=e2.
Enhetssirkelen blir en ellipse med halvakser 2 og 1. Disse lengdene er nettopp singulærverdiene.
Hurtigsjekk 15. For A=diag(3,1/2), finn bildene av e1,e2 og beskriv ellipsen.
Løsning
Fasit:Ae1=3e1 og Ae2=(1/2)e2. Ellipsen har vannrett halvakse 3 og loddrett halvakse 1/2.
Forklaring: Bildene av enhetsvektorene viser halvaksenes retninger og lengder direkte.
Rang-1-summen og virkningen på en vektor
Den kompakte SVD-en kan skrives
A=i=1∑rσiuivi⊤,
der hvert uivi⊤ er en rang-1-matrise. Når matrisen virker på x, får vi
Ax=i=1∑rσi⟨vi,x⟩ui.
Formelen måler først hvor mye av x som ligger i hver vi-retning og bygger deretter outputen i den tilhørende ui-retningen.
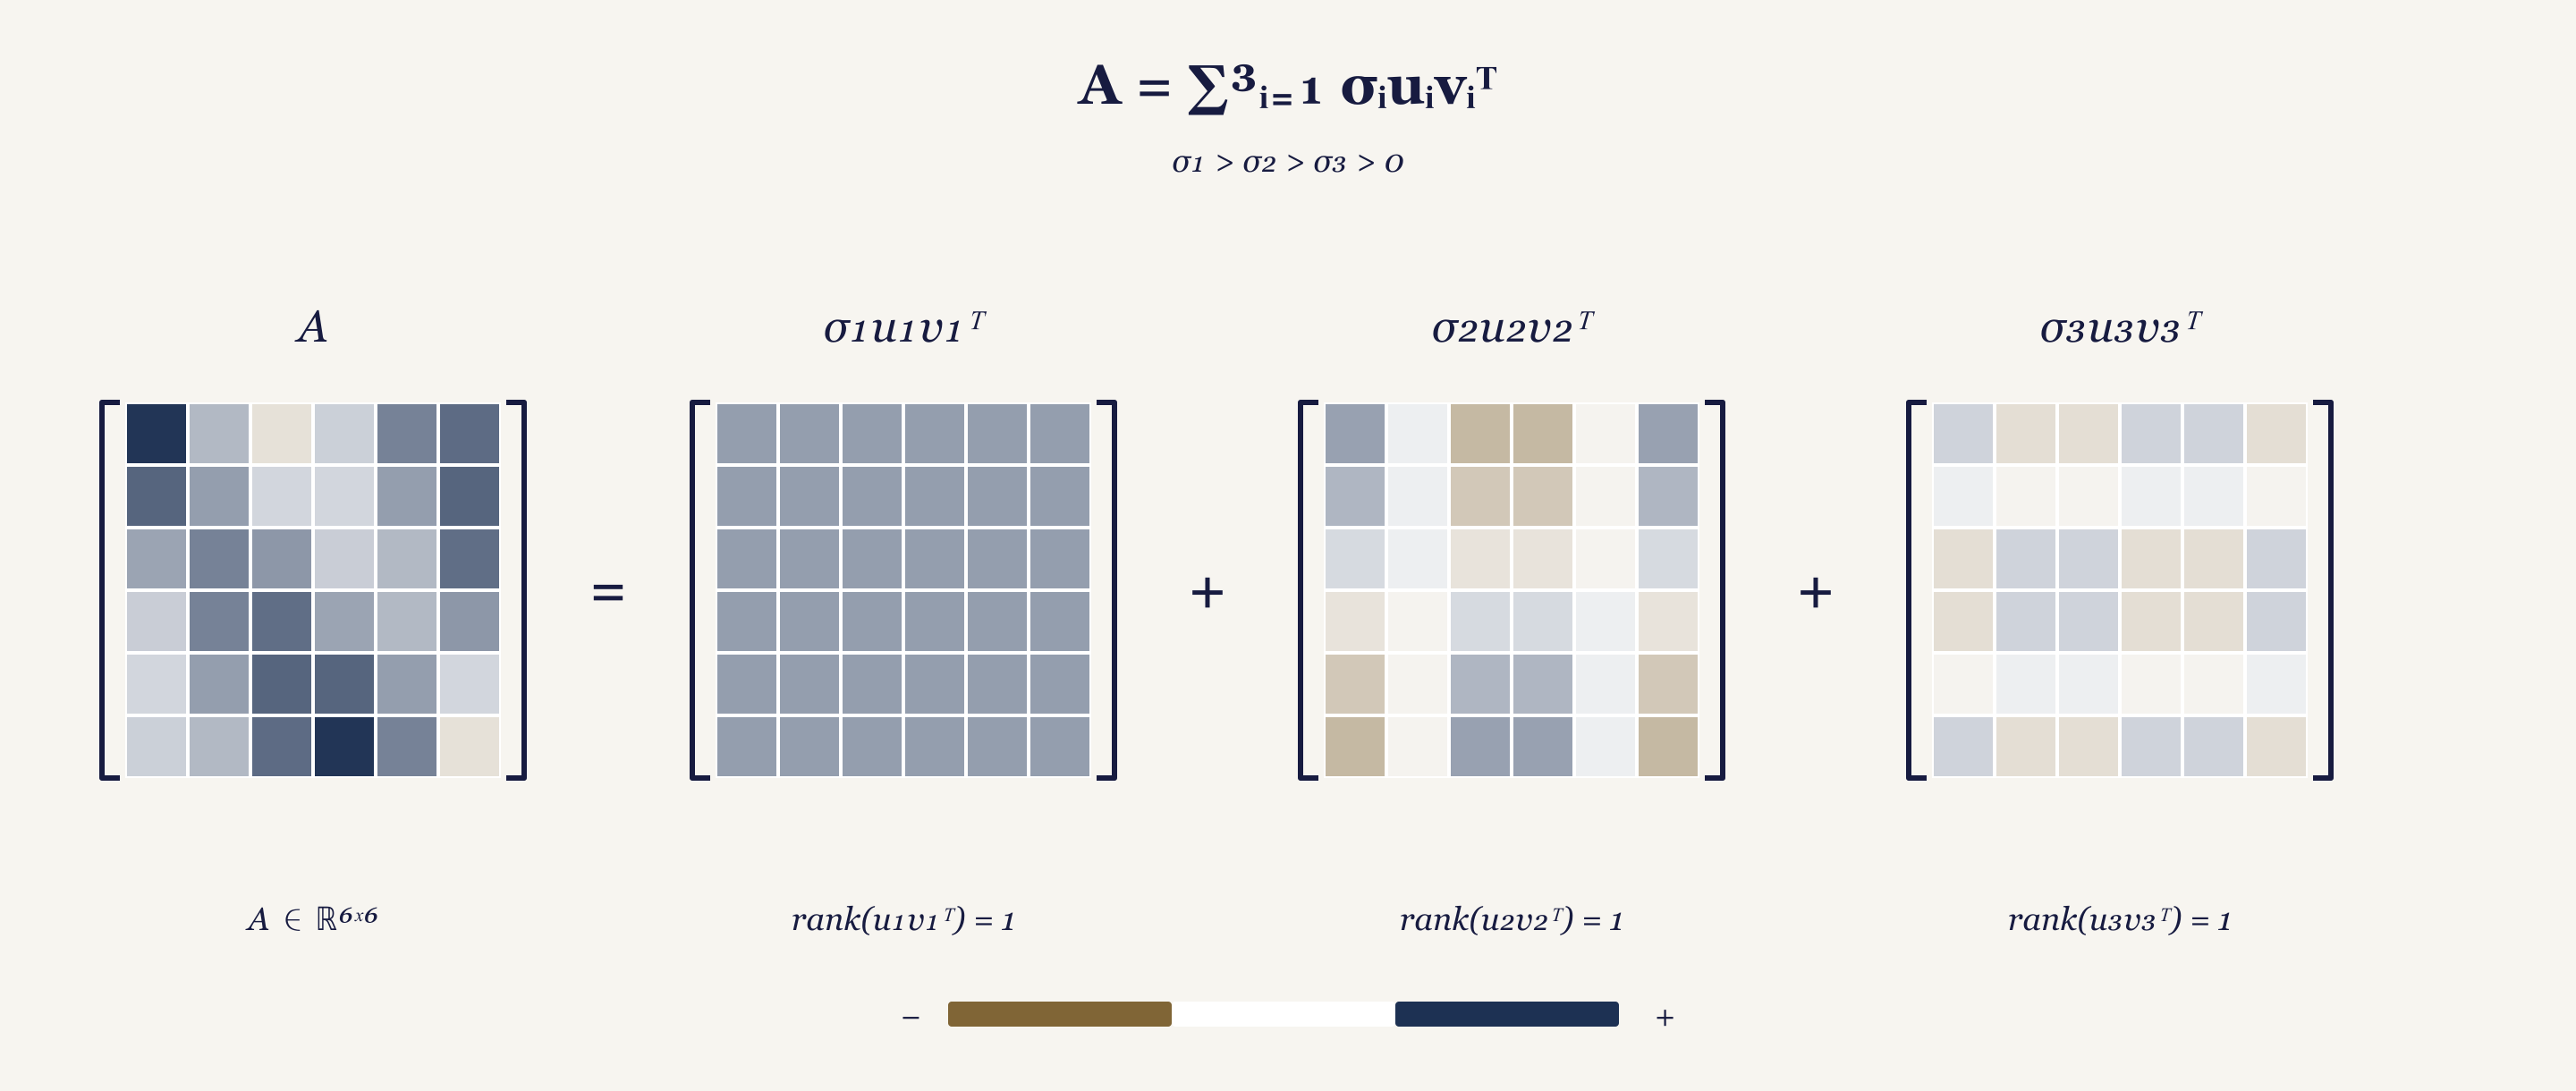
En matrise bygges som en sum av vektede rang-1-lag. De første lagene har størst vekt fordi singulærverdiene er sortert.Full størrelse / Full size ↗
Se dette i praksis
Gjennomregnet minieksempel 16. For A=diag(3,1) er
A=3(10)(10)+1(01)(01)=(3001).
Hurtigsjekk 16. Skriv D=diag(4,2) som en sum av to vektede rang-1-matriser, og bruk summen til å regne ut
D(13).
Løsning
Fasit:
D=4e1e1⊤+2e2e2⊤.
Dermed er
D(13)=4⟨e1,(13)⟩e1+2⟨e2,(13)⟩e2=(46).
Forklaring: De to indreproduktene leser av inputkoordinatene 1 og 3. Deretter skaleres de med 4 og 2.
Rang og singulærverdier lik null
La r være antallet positive singulærverdier; for nullmatrisen setter vi r=0. Da er
A=i=1∑rσiuivi⊤,
fordi singulærverdier lik null ikke bidrar.
Se dette i praksis
Gjennomregnet minieksempel 17. For A=diag(2,0) er singulærverdiene 2,0. Bare én er positiv, så r=1 og rank(A)=1. Den andre inputretningen kollapser til null.
Hurtigsjekk 17. Finn rangen til D=diag(5,0,0), og identifiser den aktive og de kollapsede koordinatretningene.
Løsning
Fasit:rank(D)=1. e1 er aktiv, mens e2 og e3 kollapser.
Forklaring: Bare σ1=5 er positiv. Null-singulærverdiene bidrar ingen aktive retninger.
Du trenger ikke bygge opp A på nytt for å lese disse egenskapene. De ligger allerede i singulærverdiene og singulærvektorene.
Se dette i praksis
Gjennomregnet minieksempel 18. For A=diag(4,0) er r=1, ∥A∥2=4, ∥A∥F=4, og
range(A)=span{e1},ker(A)=span{e2}.
Hurtigsjekk 18. For A=(300200), finn rang, verdirom, kjerne, spektralnorm og Frobenius-norm.
Løsning
Fasit: Rangen er 2, verdirommet er R2, og ker(A)=span{e3}. Dessuten er
∥A∥2=3,∥A∥F=32+22=13.
Forklaring: De positive singulærverdiene er 3,2. Den tredje inputkoordinaten har singulærverdi null og kollapser.
Trunkert SVD
For 0≤k≤r definerer vi
Ak=i=1∑kσiuivi⊤.
Ak beholder de k sterkeste singulærretningene og har rang høyst k.
Eckart–Young-teoremet
For 0≤k<r løser Ak begge problemene
rank(B)≤kmin∥A−B∥2ogrank(B)≤kmin∥A−B∥F.
De optimale feilene er
∥A−Ak∥2=σk+1,∥A−Ak∥F=(i=k+1∑rσi2)1/2.
For k=r er Ak=A, og begge feilene er null.
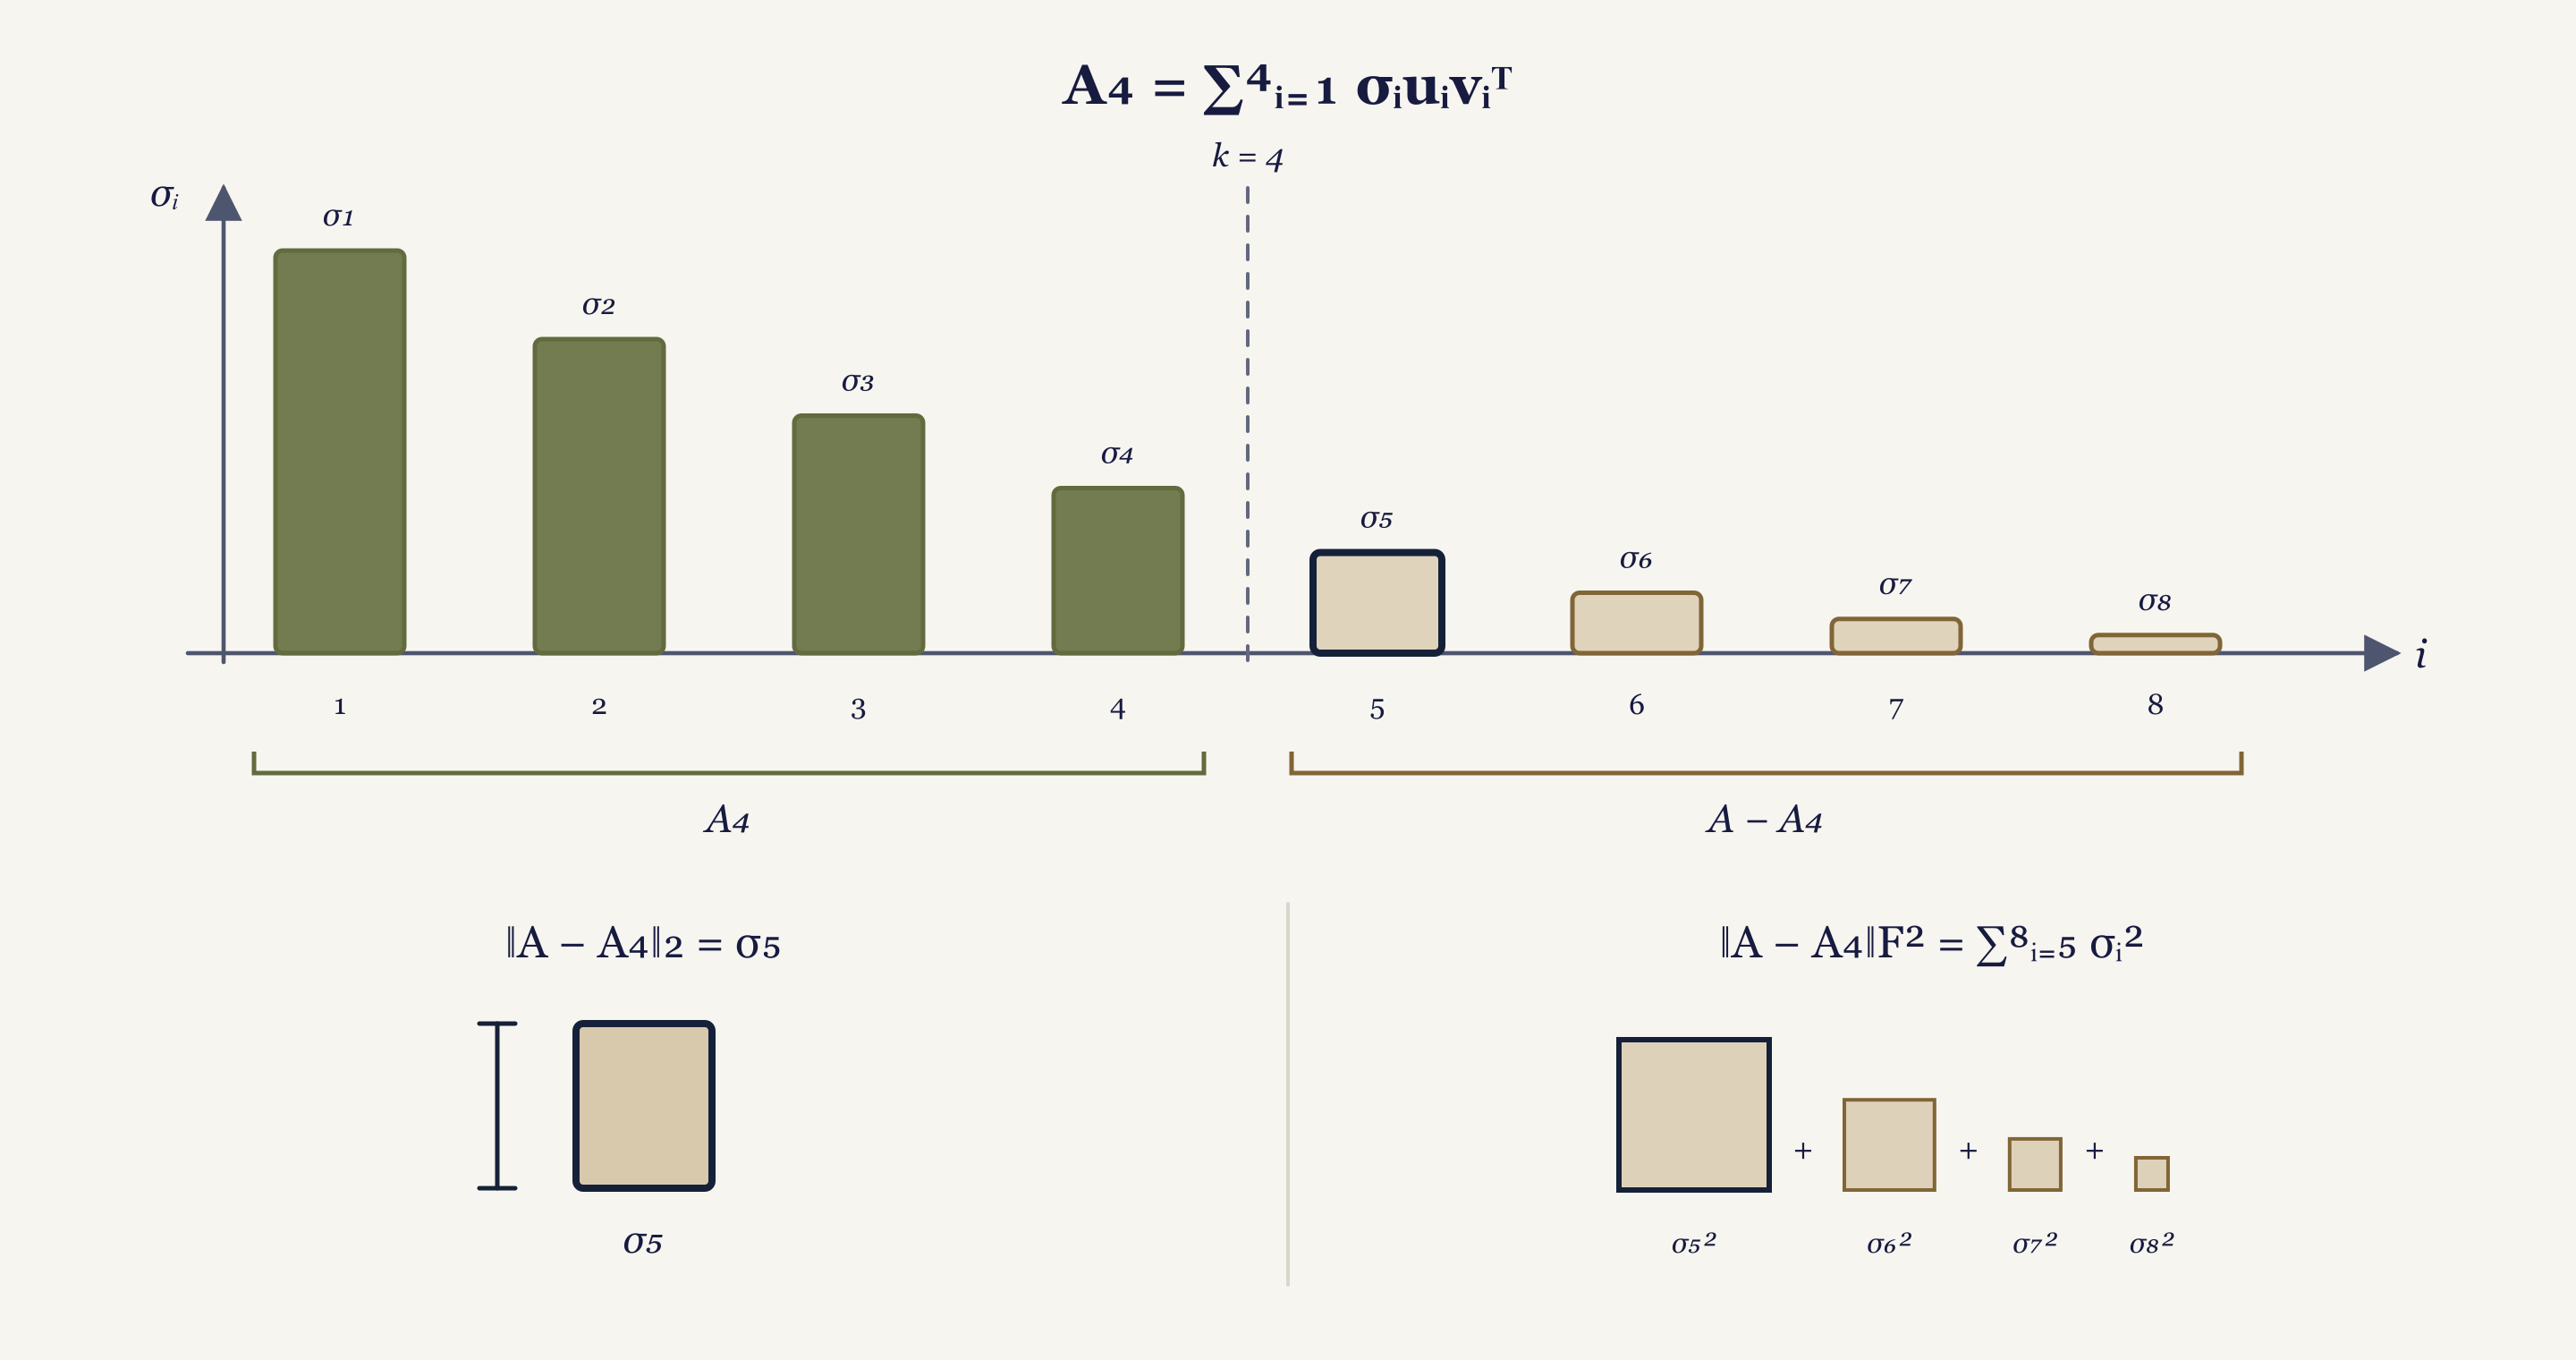
Et fallende singulærverdispekter der de første verdiene beholdes og halen forkastes. Spektralfeilen styres av den første forkastede verdien, mens Frobenius-feilen bruker hele halen.Full størrelse / Full size ↗
Eksempel: beste rang-1-approksimasjon
Se dette i praksis
Gjennomregnet minieksempel 19. For A=diag(5,1) er den beste rang-1-approksimasjonen
A1=diag(5,0).
Residualen er diag(0,1), så
∥A−A1∥2=1,∥A−A1∥F=1.
Hurtigsjekk 19. Finn den beste rang-1-approksimasjonen til D=diag(6,2) og begge feilnormene.
Løsning
Fasit: Behold den største singulærverdien 6:
D1=diag(6,0).
Den eneste forkastede singulærverdien er 2, så
∥D−D1∥2=∥D−D1∥F=2.
Forklaring: Den eneste forkastede singulærverdien er 2, så både den største forkastede retningen og hele haleenergien har størrelse 2.
Hvorfor teoremet er optimalt
Halen A−Ak har selv en SVD med singulærverdier σk+1,…,σr.
Det gir de to feilformlene direkte.
For å se hvorfor ingen annen rang-k-matrise B kan gjøre det bedre, observer at ker(B) må ha en ikke-null enhetsvektor z i span{v1,…,vk+1}.
Da er Bz=0 og
∥(A−B)z∥2=∥Az∥2≥σk+1.
Dette nullromsargumentet beviser den nedre grensen i spektralnorm.
For Frobenius-normen roterer vi inn i singulærvektorkoordinatene og bruker Pytagoras.
En rang-k-matrise kan høyst fange energien ∑i=1kσi2, så haleenergien ∑i=k+1rσi2 kan ikke unngås.
Trunkeringen Ak oppnår begge de nedre grensene.
For forelesningsmatrisen fra Del 2 er det beste rang-1-leddet
A1=σ1u1v1⊤=222222,
og begge feilene er lik den eneste forkastede singulærverdien σ2=2.
Lagring av en trunkert SVD
Lagring av Ak=UkΣkVk⊤, med singulærverdiene lagret som en liste, krever
mk+k+nk=k(m+n+1)
tall i stedet for mn. Dette er nyttig bare når k(m+n+1)≪mn og de forkastede singulærverdiene er små nok.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 4 · Moore–Penrose-inversen
Fra invers til pseudoinvers
Start med den kompakte SVD-en
A=UrΣrVr⊤.
Her inneholder Σr bare de r positive singulærverdiene. Pseudoinversen er
A†=VrΣr−1Ur⊤.
Les formelen fra høyre mot venstre:
Ur⊤ måler hvor mye av dataene som ligger i hver mulig output-retning.
Σr−1 angrer de positive strekkene.
Vr bygger en inputvektor av resultatet.
Retninger som A har knust til null, finnes ikke i Σr−1. Vi forsøker altså aldri å regne ut 1/0.
De fire vanligste eksamensvariantene er:
Situasjon
Raskeste formel
Hva svaret betyr
A er kvadratisk og invertibel
A†=A−1
én eksakt løsning
A er høy og har full kolonnerang
A†=(A⊤A)−1A⊤
entydig minste-kvadraters løsning
A er bred og har full radrang
A†=A⊤(AA⊤)−1
eksakt løsning med minst norm
A har rangmangel
A†=VrΣr−1Ur⊤
beste tilpasning først, minst norm etterpå
Fire tilfeller, fire utregninger
Laster interaktiv modell / Loading interactive model …
Ikke velg en kortformel før du har kontrollert rangbetingelsen. SVD-formelen virker alltid.
Se dette i praksis
Gjennomregnet minieksempel 20. La
D=diag(4,2,0),b=865.
Matrisen strekker de to første retningene med 4 og 2, men knuser den tredje retningen helt. Derfor finnes ikke D−1. Pseudoinversen snur bare strekkene som fortsatt kan snus:
D†=diag(1/4,1/2,0).
Når vi bruker den på b, får vi
x†=D†b=230.
Hvorfor blir siste koordinat null? Hver vektor Dx har tredje koordinat lik null, så tallet 5 i b er en output matrisen aldri kan lage. Setter vi løsningen inn igjen, får vi
DD†b=860,b−DD†b=005.
Pseudoinversen gjør altså to ting: Den reverserer retningene som overlevde, og fjerner output-retningen som er umulig å treffe. Derfor er
D†D=DD†=diag(1,1,0),
ikke I3. Hadde den siste diagonalverdien også vært positiv, ville pseudoinversen vært den vanlige inversen, og produktet ville blitt identiteten.
Vi kan også se begge Penrose-rekonstruksjonene direkte:
DD†D=D,D†DD†=D†.
Til slutt: Alle vektorer
x=23t,t∈R,
gir den samme best mulige outputen. Den frie tredje koordinaten ligger i kjernen til D. Pseudoinversen velger t=0, fordi
∥x∥22=22+32+t2=13+t2
er minst akkurat da.
Hvorfor dette er en invers.D† er en generalisert invers: Den
opphever de to positive strekkene og lar den kollapsede retningen være null,
der en tosidig invers er umulig.
Slik bekrefter du det. Her er
P=D†D=DD†=diag(1,1,0)
symmetrisk, PD=D og PD†=D†. Dette er nettopp de to
rekonstruksjonsbetingelsene og de to symmetribetingelsene i de fire
Moore–Penrose-betingelsene.
Hurtigsjekk 20. La
D=diag(5,2,0),b=1587.
a) Finn D†.
b) Regn ut x†=D†b.
c) Regn ut DD†b, og forklar hva som skjer med tallet 7.
d) Beskriv alle minste-kvadraters løsninger, og forklar hvorfor x† har minst norm.
e) Forklar hvorfor D† teller som en generalisert invers, og bekreft
det med rekonstruksjons- og symmetrikontrollene.
Løsning
Steg 1: Snu bare de positive strekkene.
D†=diag(1/5,1/2,0).
Nullen skal forbli null. Vi skal ikke prøve å dele på den.
Steg 2: Bruk pseudoinversen på dataene.
x†=D†b=(1/5)15(1/2)80⋅7=340.
Steg 3: Send løsningen gjennom D igjen.
DD†b=D340=1580.
De to første koordinatene kan gjenskapes nøyaktig. Den siste kan aldri gjenskapes, fordi tredje rad i D er null. Derfor blir residualen
b−DD†b=007.
Det er akkurat den delen av b som ligger utenfor verdirommet til D.
Steg 4: Finn friheten i kjernen.
Alle vektorer
x=34t
gir samme tilpassede output, fordi den siste kolonnen i D er null. Normen oppfyller
∥x∥22=32+42+t2=25+t2.
Den blir minst for t=0. Derfor er
x†=340
den korteste av alle beste tilpasninger.
Hvorfor dette er en invers. Den reverserer faktorene 5 og 2 i
retningene som overlever, og lar nullretningen være null.
Slik bekrefter du det. Med
P=D†D=DD†=diag(1,1,0)
har vi P⊤=P, PD=D og PD†=D†. Dermed er
DD†D=D, D†DD†=D†, og begge
projektorproduktene er symmetriske.
Høye matriser: minste kvadrater
Anta at
A∈Rm×n,m>n,rank(A)=n.
Matrisen har flere rader enn kolonner og full kolonnerang. Hvis
A=UΣV⊤
er den reduserte SVD-en, er Σ∈Rn×n invertibel. Da kan vi skrive
A†=VΣ−1U⊤∈Rn×m.
Her bytter formen retning: A er m×n, mens A† er n×m.
Produktene i de to rekkefølgene gjør forskjellige jobber:
A†A=In,AA†=UU⊤=Prange(A).
Når Ax=b har flere ligninger enn ukjente, kan kravene motsi hverandre. Minste kvadrater betyr da
x†=x∈Rnargmin∥Ax−b∥2.
Hvis A har full kolonnerang, er denne løsningen entydig og
x†=A†b.
Se dette i praksis
Gjennomregnet minieksempel 21. Fra fire punkter til en Moore–Penrose-invers.
Vi tilpasser en linje
q(t)=x1+x2t
til de fire datapunktene
(−1,0,4),(0,2,2),(1,3,4),(2,5,0).
Her inneholder x=(x1,x2)⊤ konstantleddet og stigningstallet. Vektoren
x inneholder ikke inputverdiene ti. Ett datapunkt blir én rad. For
eksempel er
q(1)=x1+x2≈3,4⟺(11)(x1x2)≈3,4.
Når vi stabler de fire radene, får vi
A=1111−1012,b=0,42,23,45,0,Ax≈b.
Dimensjonene forteller allerede hva som skjer:
(4×2)(2×1)=(4×1).
De to kolonnene i A er ikke multipler av hverandre. Derfor har A full
kolonnerang, og vi kan bruke
A†=(A⊤A)−1A⊤.
Steg 1: Transponer A. Radene blir kolonner:
A⊤=(1−1101112)∈R2×4.
Steg 2: Dann A⊤A. En 2×4-matrise ganger en
4×2-matrise gir en 2×2-matrise:
Du skal ikke forvente at AA†=I4. Dette produktet er den symmetriske
projeksjonen
AA†=101741−243211234−2147.
Den projiserer en datavektor på det todimensjonale kolonnerommet til A.
Symmetrien, sammen med A†A=I2, gir også en kort kontroll av de fire
Moore–Penrose-betingelsene.
Hvorfor dette er en invers. Siden A har full kolonnerang, er
A† en venstreinvers: A†A=I2. Den gjenfinner enhver
koeffisientvektor eksakt, selv om en tosidig invers ikke kan finnes for en
4×2-matrise.
Slik bekrefter du det. Multiplikasjonen over gir numerisk
A†A=I2. Produktet i motsatt rekkefølge, AA†, er
symmetrisk og en projeksjon. Derfor er AA†A=A og
A†AA†=A†, slik Moore–Penrose-betingelsene krever.
Hurtigsjekk 21. La
B=101011.
Finn B† med (B⊤B)−1B⊤, oppgi dimensjonen, og kontroller
B†B=I2. Forklar hvorfor dette gjør B† til en invers i det
høye tilfellet, og bekreft at BB† er en symmetrisk projeksjon.
Løsning
Steg 1: Bygg og inverter Gram-matrisen.
B⊤B=(2112),(B⊤B)−1=31(2−1−12).
Steg 2: Multipliser med B⊤.
B†=31(2−1−1211)∈R2×3.
Steg 3: Kontroller riktig identitet.
B†B=31(3003)=I2.
Hvorfor dette er en invers. Identiteten B†B=I2 sier at
B† opphever B på enhver inputvektor. Derfor er den en
venstreinvers.
Slik bekrefter du det. I motsatt rekkefølge får vi
BB†=312−11−121112,
som er symmetrisk. Sammen med B†B=I2 gir dette
BB†B=B, B†BB†=B† og begge
symmetribetingelsene.
Se dette i praksis
Gjennomregnet minieksempel 22. Bruk pseudoinversen til å finne linjen. Vi
fortsetter med matrisen, dataene og pseudoinversen fra minieksempel 21.
Residualen står dermed vinkelrett på begge kolonnene i A. Ingen gjenværende
endring av konstantledd eller stigningstall kan redusere den kvadrerte feilen.
Hvorfor dette er en invers. Fra minieksempel 21 har vi
A†A=I2. Dermed er A† en venstreinvers som gjenfinner
koeffisientvektorer eksakt. For data utenfor kolonnerommet projiserer den først
dataene på de mulige outputene.
Slik bekrefter du det. Kontroller både A†A=I2 og den numeriske
optimalitetskontrollen A⊤e=0 over. Den første bekrefter
inversegenskapen; den andre bekrefter at x†=A†b er
minste-kvadratersløsningen.
Hurtigsjekk 22. Bruk
B=101011,c=124,
og B† fra Hurtigsjekk 21. Regn ut de to radene i
x†=B†c hver for seg. Finn deretter hver prediksjon i
Bx†, hver komponent og hvert kvadrat i residualen r=c−Bx†,
den kvadrerte feilen ∥r∥22 og feilen ∥r∥2. Forklar til slutt hvorfor
B† teller som en invers her, og oppgi hvordan resultatet bekreftes.
Steg 3: Regn ut residualen og begge feilkonvensjonene.
Bx†=4/37/311/3,r=c−Bx†=−1/3−1/31/3.
Hvert residualkvadrat vises separat:
(−31)2=91,(−31)2=91,(31)2=91.
Dermed
∥r∥22=91+91+91=31,∥r∥2=31=31.
Steg 4: Kontroller ortogonaliteten.
B⊤r=(r1+r3r2+r3)=(00).
Dermed er residualen vinkelrett på hele kolonnerommet.
Hvorfor dette er en invers. Hurtigsjekk 21 viste B†B=I2, så
B† er en venstreinvers: Den opphever B eksakt på
koeffisientvektorer.
Slik bekrefter du det. Bruk matrisekontrollen B†B=I2 og
løsningskontrollen B⊤r=0. Det symmetriske produktet BB† fra
Hurtigsjekk 21 bekrefter at den tilpassede vektoren er den ortogonale
projeksjonen av c.
Bevisideen, én linje om gangen
Jeg vet at dette ser helt jævlig ut ved første øyekast, men hvert likhetstegn gjør bare én ting.
Siden ΣV⊤∈Rn×n er invertibel, kan vi skrive inputen som
x=VΣ−1y.
Da blir
Ax=UΣV⊤VΣ−1y=Uy.
Dermed er problemet
xmin∥Ax−b∥22
det samme som
ymin∥Uy−b∥22.
Kolonnene i U er ortonormale. Derfor er punktet Uy nærmest b den ortogonale projeksjonen
Uy=UU⊤b.
Multipliser med U⊤:
y=U⊤b.
Sett dette tilbake i uttrykket for x:
x=VΣ−1U⊤b=A†b.
Det er hele bevisideen: roter, projiser, angre strekket, roter tilbake.
Se dette i praksis
Gjennomregnet minieksempel 23. Visualiser linjen og endre polynomgraden.
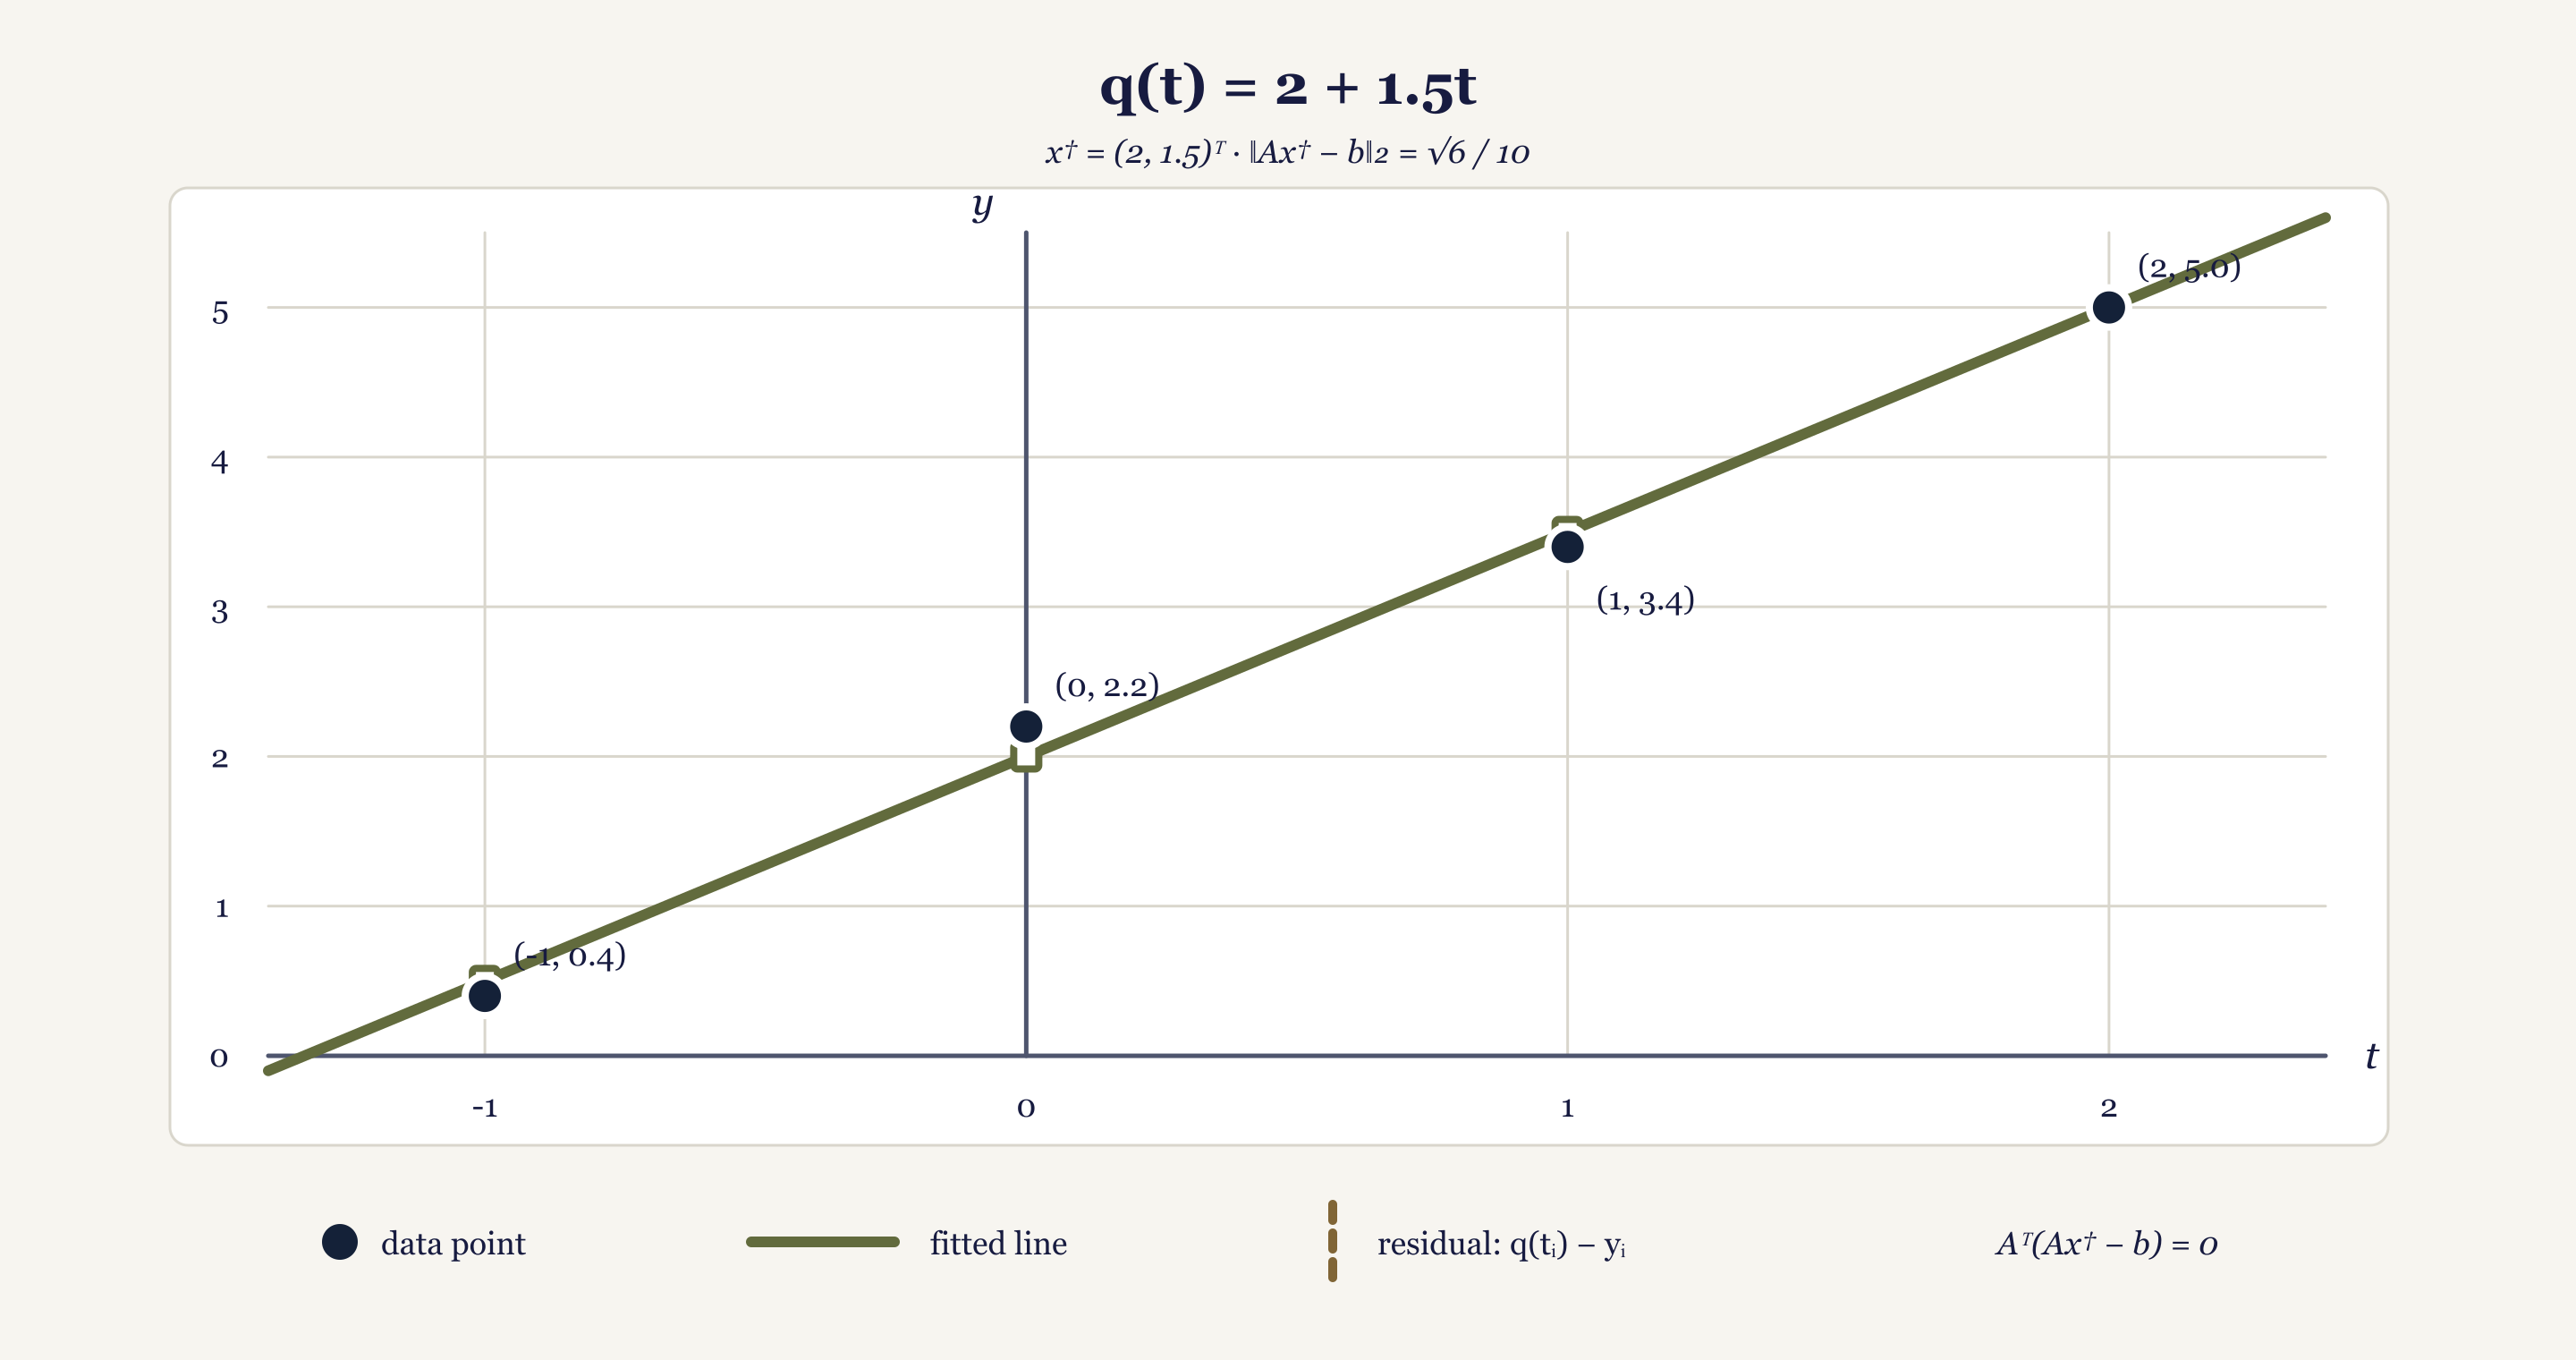
Den heltrukne linjen under er resultatet fra minieksempel 22. Hvert loddrette
linjestykke er én komponent i Ax†−b.
Fire datapunkter, den tilpassede linjen q(t)=2+1,5t og de fire loddrette residualene.Full størrelse / Full size ↗
Konstantleddet 2 er den tilpassede verdien ved t=0. Stigningstallet
1,5 sier at den tilpassede verdien øker med 1,5 når t øker med én.
Linjen bommer litt på tre punkter fordi fire dataverdier stiller fire krav til
bare to koeffisienter.
Matrisen viser hvordan vi endrer modellen. Kolonnene er basisfunksjonene
evaluert i datapunktene. Et andregradspolynom legger til kolonnen t2:
A2=1111−10121014∈R4×3.
Matrisen er fortsatt høy og har full kolonnerang. Derfor er
A2†=(A2⊤A2)−1A2⊤.
For disse dataene blir andregradstilpasningen
q2(t)=2,05+1,55t−0,05t2,∥A2x−b∥2=105≈0,224.
Et tredjegradspolynom legger til enda en kolonne:
A3=1111−10121014−1018∈R4×4.
De fire inputverdiene er forskjellige. Derfor er denne kvadratiske
Vandermonde-matrisen inverterbar. Dette er den viktige endringen:
Tredjegradspolynomet interpolerer dermed alle fire datapunktene eksakt:
q3(t)=511+34t−103t2+61t3,∥A3x−b∥2=0.
Null feil i disse fire punktene garanterer ikke bedre prediksjoner mellom
eller utenfor dem. Det betyr bare at et tredjegradspolynom har nøyaktig fire
koeffisienter til de fire interpolasjonskravene.
Hvorfor disse er inverser. De høye matrisene A og A2 har full
kolonnerang, så pseudoinversene deres er venstreinverser. Den kvadratiske
fullrangsmatrisen A3 er annerledes: Pseudoinversen er den vanlige tosidige
inversen.
Slik bekrefter du dem. For de høye tilpasningene kontrollerer du
A†A=I2, A2†A2=I3 og residualortogonalitet. For den
kvadratiske matrisen i tredjegradsmodellen gir direkte multiplikasjon i begge
rekkefølger
A3†A3=A3A3†=I4.
Hurtigsjekk 23. For B, c og x† fra Hurtigsjekk 22: Beskriv
range(B) med koordinater, og bruk residualen til å forklare
hvorfor Bx† er punktet i kolonnerommet som ligger nærmest c.
Forklar hvorfor B† teller som en invers for denne høye matrisen, og
oppgi de avsluttende matrise- og residualkontrollene.
Løsning
Steg 1: Beskriv de mulige outputene.
range(B)=⎩⎨⎧αβα+β:α,β∈R⎭⎬⎫.
Steg 2: Bruk residualtesten.
Fra forrige sjekk har vi
Bx†=4/37/311/3,r=−1/3−1/31/3.
Siden B⊤r=0, står r vinkelrett på begge retningene som spenner opp kolonnerommet. Derfor kan ingen annen mulig output ligge nærmere c.
Hvorfor dette er en invers. Siden B har full kolonnerang, er
B†B=I2: B† er en venstreinvers på koeffisientvektorer.
Slik bekrefter du det. Matrisekontrollen er B†B=I2, som ble
regnet ut i Hurtigsjekk 21. Datakontrollen er B⊤r=0, som ble regnet ut
over. Produktet BB† er en symmetrisk projeksjon på
range(B).
Brede matriser: løsningen med minst norm
Anta at
A∈Rm×n,m<n,rank(A)=m.
Matrisen har flere kolonner enn rader og full radrang. Med redusert SVD er
A†=VΣ−1U⊤∈Rn×m.
Nå er identitetene snudd sammenlignet med den høye matrisen:
AA†=Im,A†A=VV⊤=Pker(A)⊥.
Et underbestemt system har flere ukjente enn ligninger. Under antakelsen om full radrang er hverb∈Rm oppnåelig, så systemet er alltid konsistent. Rang–nullitet gir dessuten
dimker(A)=n−m>0,
så det finnes alltid uendelig mange eksakte løsninger. Pseudoinversen løser
xmin∥x∥2slik at Ax=b.
Se dette i praksis
Gjennomregnet minieksempel 24. Finn pseudoinversen til den brede matrisen
A=(100111).
Bygg først den lille 2×2-matrisen
AA⊤=(2112).
Inversen er
(AA⊤)−1=31(2−1−12).
Dermed
A†=A⊤(AA⊤)−1=312−11−121.
Pseudoinversen har form 3×2. Riktig kontroll for denne fulle radrangen er
AA†=31(100111)2−11−121=31(3003)=I2.
Hvorfor dette er en invers. Identiteten AA†=I2 gjør
A† til en høyreinvers: Den gjenskaper enhver mulig output eksakt.
Slik bekrefter du det. I tillegg til multiplikasjonen over kontrollerer du
at
A†A=312−11−121112
er symmetrisk. Dette er den ortogonale projeksjonen som fjerner
inputkomponenter i ker(A).
Hurtigsjekk 24. La
B=(10011−1).
Finn B† med B⊤(BB⊤)−1, oppgi dimensjonen og kontroller
BB†=I2. Forklar hvorfor dette gjør B† til en invers i det
brede tilfellet, og bekreft at B†B er en symmetrisk projeksjon.
Løsning
Steg 1: Bygg og inverter Gram-matrisen.
BB⊤=(2−1−12),(BB⊤)−1=31(2112).
Steg 2: Multipliser fra venstre med B⊤.
B†=3121112−1∈R3×2.
Steg 3: Kontroller høyreinversen.
BB†=31(3003)=I2.
Hvorfor dette er en invers. Identiteten BB†=I2 sier at
B† er en høyreinvers: Hvis vi først bruker B† og deretter
B, får vi enhver outputvektor uendret tilbake.
Slik bekrefter du det. I motsatt rekkefølge får vi
B†B=3121112−11−12,
som er symmetrisk. Dermed er dette den ortogonale projeksjonen på
ker(B)⊥, mens BB†=I2 bekrefter høyreinversegenskapen.
Se dette i praksis
Gjennomregnet minieksempel 25. Løs
Ax=b,b=(33),
med matrisen fra minieksempel 24. Pseudoinversen gir
x†=A†b=312−11−121(33)=112.
Dette er en eksakt løsning:
Ax†=(1+21+2)=(33)=b.
Men den er ikke den eneste. Alle løsninger kan skrives
x=112+t−1−11,t∈R.
Den siste vektoren ligger i kjernen til A. Dessuten er den ortogonal på x†, så
∥x∥22=∥x†∥22+3t2=6+3t2.
Normen er minst for t=0.
Hvorfor dette er en invers. Minieksempel 24 viste AA†=I2, så
A† er en høyreinvers og garanterer Ax†=b for enhver
b∈R2.
Slik bekrefter du det. Her er
x†⋅−1−11=−1−1+2=0.
Høyreinverskontrollen bekrefter eksakthet, og denne ortogonaliteten til
ker(A) bekrefter at ingen kjernevektor kan gjøre løsningen kortere.
Hurtigsjekk 25. Bruk
B=(10011−1),c=(11).
Finn x†=B†c. Skriv deretter alle eksakte løsninger som x†+tz, der z spenner opp ker(B), og forklar hvorfor t=0 gir minst norm.
Forklar hvorfor B† teller som en invers i dette brede tilfellet, og
oppgi både eksakthets- og minstenormskontrollen.
Løsning
Steg 1: Finn pseudoinversløsningen.
x†=3121112−1(11)=110.
Steg 2: Finn kjernefriheten.
Ligningene er x1+x3=1 og x2−x3=1. Derfor
x=110+t−111.
Steg 3: Sammenlign normene.
Kjernevektoren er ortogonal på x† fordi −1+1+0=0. Dermed
∥x∥22=2+3t2,
som er minst for t=0.
Hvorfor dette er en invers. Hurtigsjekk 24 ga BB†=I2, så
B† er en høyreinvers og Bx†=c er eksakt.
Slik bekrefter du det. Kontroller BB†=I2 og
x†⋅−111=−1+1+0=0.
Den første testen bekrefter inversegenskapen; den andre bekrefter minst norm
blant alle eksakte løsninger.
Bevisideen for minst norm, én linje om gangen
Sett
x†=A†b.
Siden A har full radrang,
Ax†=AA†b=b.
Altså er x† en eksakt løsning. La y være en annen eksakt løsning. Da
Ay=b
og derfor
A†Ay=A†b=x†.
Men A†A er en ortogonal projeksjon. En projeksjon kan ikke gjøre en vektor lengre:
∥x†∥2=∥A†Ay∥2≤∥y∥2.
Dermed er pseudoinversløsningen den korteste eksakte løsningen.
Se dette i praksis
Gjennomregnet minieksempel 26. For systemet i minieksempel 25 er
x†=112.
En annen eksakt løsning er
y=330.
Forskjellen er en kjernevektor:
y−x†=22−2,A(y−x†)=0.
Sammenlign normene:
∥x†∥2=6,∥y∥2=18.
Begge treffer dataene nøyaktig. Pseudoinversen vinner bare fordi den unngår den unødvendige kjernekomponenten.
Hvorfor dette er en invers. Den samme identiteten AA†=I2 fra
minieksempel 24 gjør A† til en høyreinvers, så begge vektorene
gjenskaper den ønskede outputen.
Slik bekrefter du det. Forskjellen ligger i ker(A), og
(x†)⊤(y−x†)=2+2−4=0.
Høyreinversidentiteten bekrefter eksakthet, mens ortogonaliteten til kjernen
bekrefter at x† har minst norm.
Hurtigsjekk 26. For systemet i Hurtigsjekk 25 er
x†=110.
Vis at
y=021
også er en løsning. Finn y−x†, kontroller at forskjellen ligger i ker(B), og sammenlign normene.
Forklar hvorfor B† teller som en invers, og oppgi sluttkontrollene for
eksakthet og minst norm.
Løsning
Steg 1: Kontroller begge løsningene.
By=(0+12−1)=(11)=c.
Steg 2: Finn kjernekomponenten og normene.
y−x†=−111,B(y−x†)=0.
Videre er
∥x†∥2=2,∥y∥2=5.
Den ekstra kjernekomponenten endrer ikke outputen, men gjør løsningen lengre.
Hvorfor dette er en invers. Siden BB†=I2, er B† en
høyreinvers og Bx†=c er eksakt.
Slik bekrefter du det. I tillegg til BB†=I2 kontrollerer du
(x†)⊤(y−x†)=−1+1+0=0.
Forskjellen ligger i ker(B), så denne ortogonaliteten viser at den bare kan
øke normen.
Til venstre projiseres data på kolonnerommet i et overbestemt problem. Til høyre velges punktet med minst norm blant mange eksakte løsninger i et underbestemt problem.Full størrelse / Full size ↗
Generell rangmangel: best tilpasning først, minst norm deretter
Dette er punktet der form alene slutter å være nok. En matrise kan være høy, bred eller kvadratisk og likevel ha rangmangel.
Behold derfor én sikker regel. Hvis
A=i=1∑rσiuivi⊤=UrΣrVr⊤
er den kompakte SVD-en, så
A†=i=1∑rσi1viui⊤=VrΣr−1Ur⊤.
Bare positive singulærverdier inverteres.
Se dette i praksis
Gjennomregnet minieksempel 27. La
A=(1224),b=(36).
Matrisen er kvadratisk, men ikke invertibel: Den andre kolonnen er to ganger den første, så rank(A)=1.
Dette er også en symmetrisk positiv semidefinit rang-1-matrise. Fra SVD-eksemplet tidligere har vi
σ1=5,u1=v1=51(12).
Derfor
A†=σ11v1u1⊤=251(1224).
Løsningen blir
x†=A†b=251(1224)(36)=(3/56/5).
Multipliser tilbake:
Ax†=(36)=b.
Feilen er null fordi b ligger i verdirommet:
b=3(12).
Det finnes likevel uendelig mange løsninger:
x=(3/56/5)+t(−21).
Kjernevektoren står vinkelrett på x†. Derfor velger pseudoinversen t=0 og dermed løsningen med minst norm.
Hvorfor dette er en invers. Ingen vanlig invers finnes, men A†
reverserer den ene positive singulærretningen og lar den kollapsede retningen
være null. Det er nettopp rollen til den generaliserte inversen.
Slik bekrefter du det. Siden A2=5A, er
AA†=A†A=51A
symmetrisk, og dette gir AA†A=A og
A†AA†=A†. Dermed er alle fire
Moore–Penrose-betingelsene kontrollert.
Hurtigsjekk 27. La
C=(4221),d=(84).
a) Vis raskt at C har rang 1 og er positiv semidefinit.
b) Bruk σ1=5 til å finne C†.
c) Finn x†=C†d, kontroller Cx†=d, og beskriv alle løsninger.
d) Forklar hvorfor C† teller som en generalisert invers, og bekreft
det med rekonstruksjons- og symmetrikontrollene.
Løsning
Steg 1: Se rang-1-mønsteret.
C=(21)(21).
Dermed er C symmetrisk positiv semidefinit med rang 1 og eneste positive singulærverdi
(21)22=5.
Steg 2: Inverter den positive singulærverdien.
C†=251(4221).
Steg 3: Løs og finn kjernefriheten.
x†=C†d=(8/54/5).
Kontrollen regnes helt ut:
Cx†=(4221)(8/54/5)=(40/520/5)=(84)=d.
Siden
ker(C)=span{(−12)},
er alle løsninger
x=(8/54/5)+t(−12).
Hvorfor dette er en invers.C har ingen vanlig invers, men C†
reverserer den ene positive singulærretningen og lar ker(C) være null.
Slik bekrefter du det. Siden C2=5C, er
CC†=C†C=51C
symmetrisk. Derfor er CC†C=C og
C†CC†=C†, som bekrefter alle fire Penrose-ligningene.
Dessuten er
(x†)⊤(−12)=−58+58=0,
som bekrefter minstenormsvalget.
Moore–Penrose-inversen kjennetegnes entydig av fire ligninger:
AA†A=A,A†AA†=A†,(AA†)⊤=AA†,(A†A)⊤=A†A.
De to første sier «rekonstruer det som kan rekonstrueres». De to siste sier at projektorene er ortogonale, ikke skjeve.
Se dette i praksis
Gjennomregnet minieksempel 28. For rang-1-matrisen fra minieksempel 27 er
A†=251A.
Siden A2=5A, får vi
AA†=A†A=51A=51(1224).
Dette er den ortogonale projeksjonen på
span{(12)}.
Den er symmetrisk. Dessuten
AA†A=51A2=A,
og tilsvarende A†AA†=A†.
Hvorfor dette er en invers. Selv om A er singulær, rekonstruerer
A† alt i den overlevende singulærretningen og bruker ortogonale
projeksjoner i retningene som ikke kan inverteres.
Slik bekrefter du det. De to rekonstruksjonsligningene over og symmetrien
til både AA† og A†A er akkurat de fire
Moore–Penrose-ligningene.
Hurtigsjekk 28. Bruk C og C† fra Hurtigsjekk 27. Finn
CC† og C†C, kontroller alle fire Penrose-ligningene, og
bruk dem til å forklare hvorfor C† teller som en generalisert invers.
Løsning
Steg 1: Finn de to projektorproduktene.
Siden C2=5C,
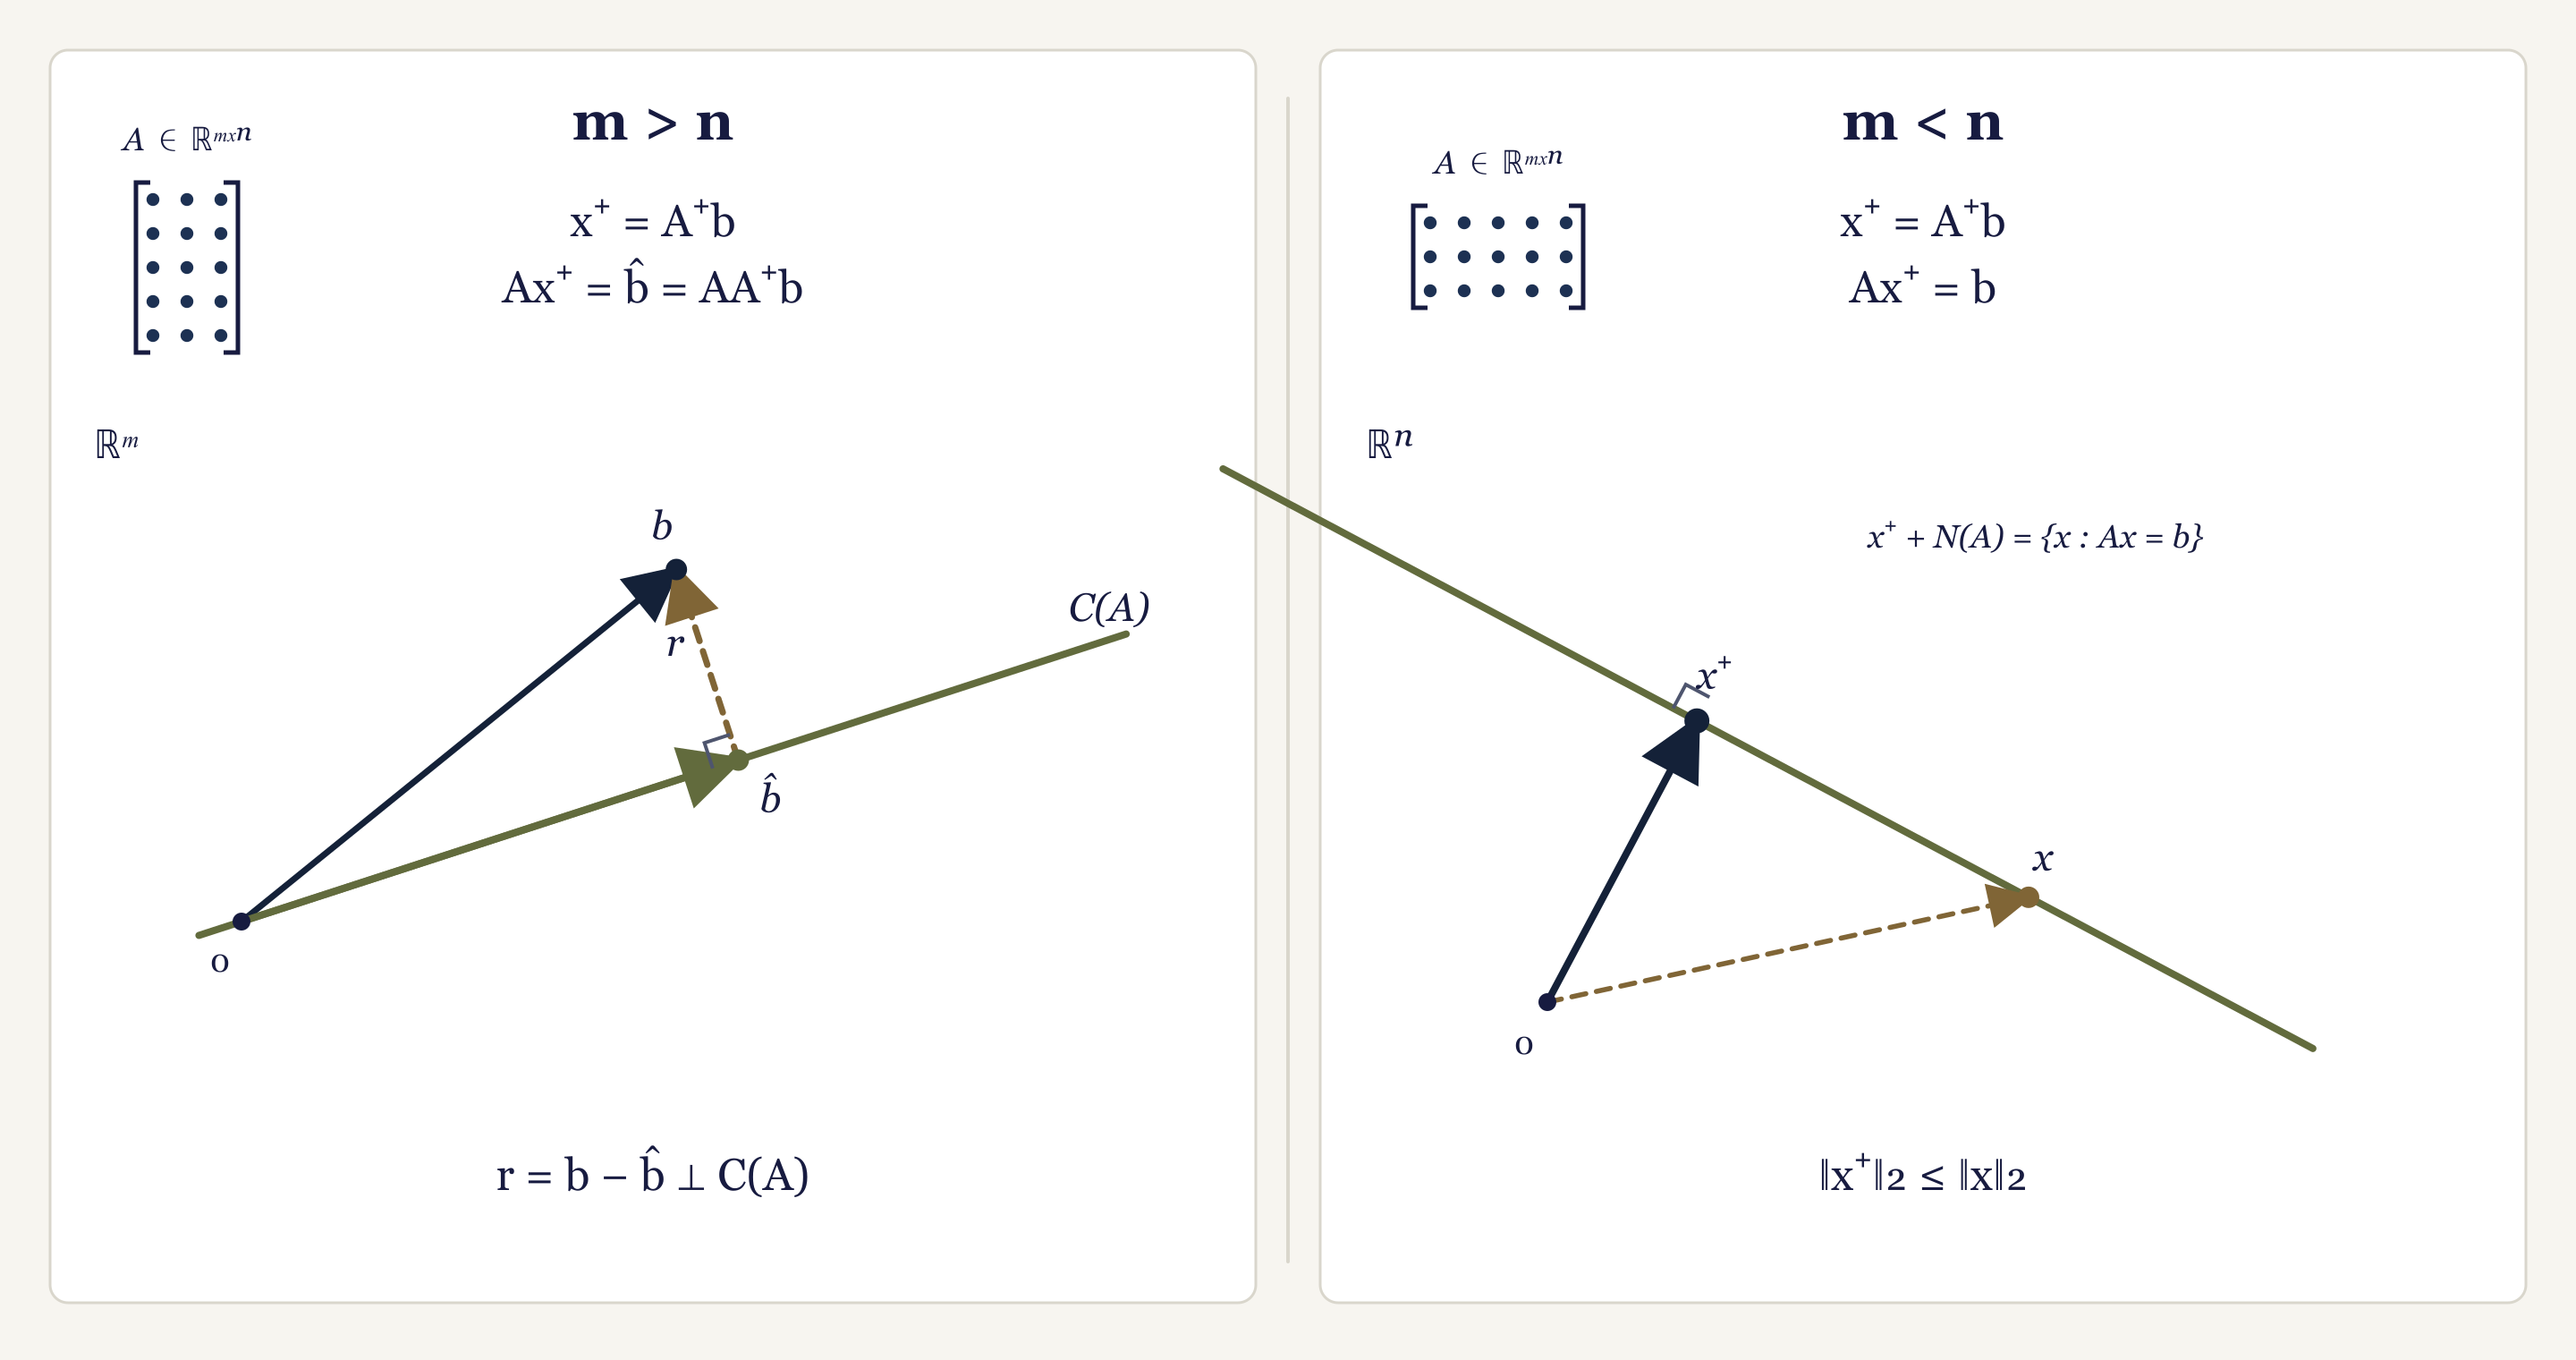
CC†=C†C=51C=51(4221).
Begge er symmetriske.
Steg 2: Kontroller rekonstruksjonene.
CC†C=51C2=C,
og
C†CC†=251C51C=1251C2=251C=C†.
Dermed holder alle fire Penrose-ligningene.
Hvorfor dette er en invers. Rekonstruksjonsidentitetene viser at vi
rekonstruerer alt som kan rekonstrueres når vi bruker C, så C†, og
så den opprinnelige avbildningen. De symmetriske produktene gjør operasjonene
til ortogonale projeksjoner.
Slik bekrefter du det. Kontroller akkurat de fire ligningene som er regnet
ut over: to rekonstruksjonsidentiteter og to symmetriidentiteter. At alle fire
holder samtidig, bekrefter entydig Moore–Penrose-inversen.
For vilkårlige A og b følger x†=A†b alltid to prioriteringer:
Minimer ∥Ax−b∥2.
Blant alle minimisatorer, velg den med minst ∥x∥2.
Se dette i praksis
Gjennomregnet minieksempel 29. Behold
A=(1224),
men bytt dataene til
b=(10).
Nå ligger ikke b på linjen
span{(12)}.
Pseudoinversen gir
x=A†b=(1/252/25).
Den best mulige outputen er
Ax=AA†b=(1/52/5).
Residualen er
b−Ax=(4/5−2/5),
med norm
b−Ax2=52.
Den står vinkelrett på verdirommet. Alle minste-kvadraters minimisatorer er
x=x+t(−21),
og pseudoinversen velger igjen t=0.
Hvorfor dette er en invers. Den samme A† som ble kontrollert i
minieksempel 28, reverserer den overlevende singulærretningen. For uoppnåelige
data gir AA† den nærmeste mulige outputen i stedet for å late som en
tosidig invers finnes.
Slik bekrefter du det. De fire Penrose-kontrollene står i minieksempel 28.
For denne datavektoren kontrollerer du i tillegg
Den første bekrefter beste tilpasning; den andre bekrefter minst norm.
Hurtigsjekk 29. Bruk
C=(4221),e=(01).
Finn x†=C†e, den best mulige outputen Cx†, residualen og residualnormen. Beskriv til slutt alle minste-kvadraters minimisatorer.
Forklar hvorfor C† teller som en generalisert invers, og oppgi både
matrise- og løsningskontrollene som bekrefter den.
Løsning
Steg 1: Finn pseudoinversløsningen.
x†=251(4221)(01)=(2/251/25).
Steg 2: Finn tilpasning og residual.
Cx†=(2/51/5),r=e−Cx†=(−2/54/5).
Dermed
∥r∥2=52.
Steg 3: Legg til kjernefriheten.
Alle beste tilpasninger er
x=(2/251/25)+t(−12).
Pseudoinversen velger t=0, fordi kjernevektoren er ortogonal på x† og alle andre valg øker normen.
Hvorfor dette er en invers. Hurtigsjekk 28 bekreftet alle fire
Penrose-ligningene for denne C†. Dermed er den den entydige
generaliserte inversen som bruker ortogonale projeksjoner.
Slik bekrefter du det. Bruk de fire matriseidentitetene fra Hurtigsjekk 28
om igjen. For løsningen kontrollerer du numerisk at
Disse to testene bekrefter prioriteringene beste tilpasning og minst norm.
Eksempel fra den håndregnede SVD-en
Pseudoinversen bruker de samme singulærretningene som det fulle SVD-eksemplet, men reverserer bare de positive strekkene og snur rekkefølgen på ytterfaktorene. Åpne utregningen for hele matriseproduktet og begge projeksjonskontrollene.
Full utregning: pseudoinversen til den håndregnede matrisen
For den korrigerte forelesningsmatrisen
A=123321
bruker vi SVD-en fra Del 2.
Steg 1: inverter bare de positive singulærverdiene.
Σr−1=(1/24001/2).
Steg 2: snu rekkefølgen på singulærvektorfaktorene. Formelen er A†=VrΣr−1Ur⊤, ikke UrΣr−1Vr⊤. Dimensjonene er
Steg 4: kontroller identiteten som passer for en høy matrise med full kolonnerang.
A†A=I2.
Det motsatte produktet er en 3×3-projeksjon, ikke I3:
AA†=5/61/3−1/61/31/31/3−1/61/35/6.
Det projiserer data på det todimensjonale kolonnerommet til A.
Uavhengig Axia-kontroll. For A=201021 inverterer vi 6 og 2 i den uavhengige SVD-en fra Del 2. Det gir
A†=(5/12−1/12−1/125/121/61/6),
og direkte multiplikasjon bekrefter A†A=I2. Begge eksemplene viser at det er metoden, ikke ett bestemt sett med tall, som skal gjenbrukes.
Hvorfor dette er en invers. Begge matrisene er høye og har full
kolonnerang. Derfor er pseudoinversene venstreinverser som gjenfinner enhver
vektor i det todimensjonale koeffisientrommet eksakt.
Slik bekrefter du det. Multipliser i venstreinversrekkefølgen og få
A†A=I2 og
A†A=I2. I motsatt rekkefølge kontrollerer du
at AA† og AA† er symmetriske
projeksjoner. For en minste-kvadraters datavektor skal den tilhørende
residualen også oppfylle A⊤r=0.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 5 · Trunkert SVD og L-kurvemetoden
Små singulærverdier og støy
Hvorfor er støy et problem?
Pseudoinversen deler på singulærverdier.
Det er ufarlig for store verdier. For bittesmå verdier kan det være katastrofalt.
La de målte dataene være
bδ=b+nδ,∥nδ∥2≤δ,
og la x†=A†b. Den uregulariserte løsningen fra de støyete dataene er
xδ=A†bδ=x†+A†nδ.
Når r≥1, er ∥A†∥2=1/σr, så den eksakte formelen for verst mulig forsterkning er
∥e∥2≤δmax∥A†e∥2=∥nδ∥2≤δmax∥xδ−x†∥2=σrδ.
Se dette i praksis
Gjennomregnet minieksempel 30. Hvis σr=0,001 og δ=0,01, er den verst mulige forsterkningen
σrδ=0,0010,01=10.
En datafeil med størrelse 0,01 kan altså skape en løsningsfeil med størrelse 10.
Hurtigsjekk 30. Finn den verste feilgrensen når σr=0,002 og δ=0,006.
Løsning
Fasit:
σrδ=0,0020,006=3.
Dermed kan datastøy med norm høyst 0,006 gi en løsningsfeil så stor som 3 i den verst orienterte retningen.
Forklaring: Operatornormen til pseudoinversen er 1/σr, så den farligste støyen peker langs den tilhørende venstre singulærretningen.
Trunkering av små singulærverdier
Løsningen er bevisst: Vi slutter å invertere retninger som er for ustabile.
For en terskel ε>0 definerer vi
Aε=σi≥ε∑σiuivi⊤,Aε†=σi≥ε∑σi1viui⊤.
For støyfrie data definerer vi xε=Aε†b; for målte data definerer vi xεδ=Aε†bδ.
Terskelen ε er tillitsgrensen. Verdier over grensen brukes; verdier under grensen forkastes.
Se dette i praksis
Gjennomregnet minieksempel 31. Anta at singulærverdiene er 5,1,0,01 og velg ε=0,1. Vi beholder 5 og 1, men forkaster 0,01. Den trunkerte pseudoinversen bruker 1/5 og 1, men unngår den farlige faktoren 1/0,01=100.
Hurtigsjekk 31. Singulærverdiene er 8,0,4,0,02, og ε=0,1. Hvilke verdier beholdes, og hvilke inverse faktorer står i Aε†?
Løsning
Fasit: Behold 8 og 0,4, forkast 0,02, og bruk faktorene 1/8 og 1/0,4=2,5.
Forklaring: Bare singulærverdier som er minst ε=0,1, regnes som pålitelige. Den farlige faktoren 1/0,02=50 tas derfor ikke med.
Oppdeling av feilen
Det er her notasjonen blir tung. Hold to bokser i hodet: Trunkering gir skjevhet selv med støyfrie data, mens beholdte små singulærverdier forsterker målestøy.
Hvis b=Ax†, er
∥xεδ−x†∥2≤∥(I−Aε†A)x†∥2+εδ.
Det første leddet er informasjon som bevisst forkastes ved trunkering. Det andre er støyforsterkning. Liten ε mister mindre informasjon, men forsterker mer støy; stor ε gjør det motsatte.
Se dette i praksis
Gjennomregnet minieksempel 32. La δ=0,01. Med ε=0,001 kan støyleddet bli så stort som 10. Med ε=0,1 er det begrenset av 0,1. Den større terskelen er mer stabil, men kan forkaste flere nyttige retninger.
Hurtigsjekk 32. La δ=0,02. Sammenlign støygrensene for ε=0,01 og ε=0,2.
Løsning
Fasit:
0,010,02=2,0,20,02=0,1.
Den større terskelen gir den minste støygrensen, men kan gi større trunkeringsfeil.
Forklaring: Støyleddet er δ/ε, så økningen fra 0,01 til 0,2 reduserer dette leddet fra 2 til 0,1.
Regulariseringsfeil uttrykt med koeffisienter
Minimumsnormløsningen ligger i span{v1,…,vr} og kan skrives
x†=i=1∑rxi†vi.
Hvis terskelen forkaster alle σi<ε, er
∥Aε†b−x†∥2=(σi<ε∑∣xi†∣2)1/2.
Dette er ikke støyfeil. Det er nyttig innhold i løsningen som vi selv valgte å fjerne.
Se dette i praksis
Gjennomregnet minieksempel 33. La
x†=3v1+4v2+12v3
og anta at terskelen forkaster den tredje retningen. Da er xε=3v1+4v2, og regulariseringsfeilen er ∥12v3∥2=12.
Hurtigsjekk 33. La x†=5v1+12v2+4v3 med ortonormale vi, og forkast den tredje retningen. Finn den trunkerte løsningen og regulariseringsfeilen.
Løsning
Fasit:
xε=5v1+12v2,x†−xε=4v3.
Siden v3 har lengde 1, er feilen 4.
Forklaring: Ortonormale retninger følger Pytagoras, og den eneste forkastede koeffisienten er 4.
Valg av k i stedet for ε
I stedet for en terskel kan vi beholde nøyaktig de første k singulærretningene:
Ak†=i=1∑kσi1viui⊤,xδ(k)=Ak†bδ.
Da er
∥xδ(k)∥22=i=1∑kσi2∣⟨ui,bδ⟩∣2,
så løsningsnormen er ikke-avtakende i k. Etter at u1,…,ur er fullført til en ortonormal basis i datarommet, er
Axδ(k)−bδ=−i=k+1∑m⟨ui,bδ⟩ui,
så residualnormen er ikke-økende. Øvre grense er m, dimensjonen til datarommet.
Se dette i praksis
Gjennomregnet minieksempel 34. For singulærverdiene 10,1,0,01 bruker k=1 bare den sterkeste retningen, k=2 tar også med faktoren 1, og k=3 deler på 0,01 og innfører faktoren 100. Større k kan gi bedre tilpasning, men en mye mindre stabil løsning.
Hurtigsjekk 34. For singulærverdiene 6,0,5,0,02, oppgi de inverse faktorene som innføres ved k=1,2,3, og identifiser det risikable trinnet.
Løsning
Fasit: Faktorene er 1/6 ved k=1, deretter 2 ved k=2, og til slutt 50 ved k=3. Det risikable trinnet er k=3.
Forklaring: Den tredje retningen deler på 0,02, så støy i denne retningen kan forstørres med 50.
L-kurvemetoden
Se dette i praksis
Gjennomregnet minieksempel 35. Anta at vi har regnet ut
k
løsningsnorm
residual
1
1
10
2
2
4
3
4
2
4
20
1,8
5
100
1,7
Fram til k=3 blir residualen mye mindre, mens løsningen vokser moderat. Etter k=3 endres residualen nesten ikke, mens løsningsnormen eksploderer. Det sannsynlige hjørnet er k=3.
Hurtigsjekk 35. Kun anvendelse: En ny tabell gir (0,8,12), (1,5,5), (3,2,2), (18,2,0) og (70,1,9) for k=1,…,5, der hvert par er (løsningsnorm, residual). Finn det sannsynlige hjørnet og begrunn valget. Dette er tolkningsøving, ikke eksamensregning.
Løsning
Fasit: Det sannsynlige hjørnet er k=3.
Forklaring: Fra k=1 til 3 faller residualen fra 12 til 2,2, mens normen bare vokser fra 0,8 til 3. Ved k=4 og 5 blir residualen knapt mindre, men normen vokser til 18 og 70.
Oppsummering
Hver reell matrise har en SVD A=UΣV⊤.
Singulærverdiene er ikke-negative kvadratrøtter av egenverdiene til A⊤A eller AA⊤.
De positive singulærverdiene bestemmer rang, verdirom, kjerne og matrise-normer.
Trunkert SVD gir den beste lavrang-approksimasjonen i både spektralnorm og Frobenius-norm.
A† reverserer singulærretninger forskjellig fra null og gir minste-kvadraters løsningen med minst norm.
Små singulærverdier forsterker støy; trunkering bytter informasjon mot stabilitet.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 6 · Tensorer
Laster interaktiv modell / Loading interactive model …
Motivasjon
Strukturerte data har ofte mer enn to naturlige retninger. Et gråtonebilde med m×n piksler kan lagres som én matrise
A∈[0,1]m×n,
der 0 betyr svart og 1 betyr hvitt. Et fargebilde trenger derimot én matrise for hver fargekanal,
R,G,B∈[0,1]m×n,
og hele bildet kan derfor samles som
X∈[0,1]m×n×3.
En film trenger røde, grønne og blå matriser for hvert bilde i=1,…,N, og får formen
X∈[0,1]m×n×3×N.
Høyde, bredde, farge og tid er fire forskjellige modi, altså retninger i dataene. En romlig film kan i tillegg ha dybde og bli femdimensjonal.
Se dette i praksis
Et gråtonebilde med 2×3 piksler kan lagres som
A=(01100,50,25).
Et fargebilde med samme størrelse trenger tre slike tabeller,
R,G,B∈R2×3.
I stedet for å behandle dem som tre løse matriser, legger vi dem i én tensor
X∈R2×3×3.
Den første modusen er høyde, den andre er bredde, og den tredje velger fargekanal. Ett bildeobjekt har altså tre naturlige retninger samtidig.
Hurtigsjekk 36. En videosnutt har 4 rader, 6 kolonner, tre fargekanaler og 8 bilder. Oppgi tensorens orden, form, betydningen av de fire modiene og antallet lagrede tall.
Løsning
Steg 1: Én indeks trengs for hver av retningene rad, kolonne, farge og tid. Tensoren har derfor orden 4.
Steg 2: Formen er
X∈R4×6×3×8.
Modus 1, 2, 3 og 4 betyr henholdsvis høyde, bredde, fargekanal og bildenummer.
Steg 3: Antallet tall er
4⋅6⋅3⋅8=576.
Definisjon av en tensor
En matrise er en tensor av orden 2 fordi hvert tall trenger to indekser. Generelt trenger en tensor av orden d nøyaktig d indekser for å angi adressen til ett tall.
Se dette i praksis
Et tall trenger ingen indeks:
x=7,
så det er en tensor av orden 0.
En vektor trenger én indeks:
x=251,x2=5,
så den har orden 1.
En matrise trenger to indekser:
A=(1245),a2,1=2,
så den har orden 2.
En tensor X∈Rm×n×p trenger tre indekser. Adressen x2,1,3 betyr andre posisjon i modus 1, første posisjon i modus 2 og tredje posisjon i modus 3.
Hurtigsjekk 37. Klassifiser q=4, v∈R5, M∈R3×2 og Y∈R3×2×4. Hvor mange indekser trenger hvert objekt, og hva betyr y2,1,4?
Løsning
Steg 1:q er en skalar av orden 0, v er en vektor av orden 1, M er en matrise av orden 2, og Y er en tensor av orden 3.
Steg 2: De trenger henholdsvis null, én, to og tre indekser for å velge én oppføring.
Steg 3:y2,1,4 er skalaren på posisjon 2 i første modus, posisjon 1 i andre modus og posisjon 4 i tredje modus.
Når j=2 er fast, samler vi kolonne 2 fra begge lag:
X:2:=(2468).
Når i=1 er fast, samler vi første rad fra begge lag:
X1::=(1256).
To kolon betyr at to indekser varierer, så alle tre resultater er matriser.
Hurtigsjekk 39. Bruk tensoren fra hurtigsjekk 38. Finn Y::2, Y:1: og Y2::, og oppgi dimensjonen til hvert snitt.
Løsning
Steg 1: Andre frontsnitt er gitt direkte:
Y::2=(1537)∈R2×2.
Steg 2: Kolonne 1 fra begge lag gir
Y:1:=(2615)∈R2×2.
Steg 3: Rad 2 fra begge lag gir
Y2::=(6857)∈R2×2.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 8 · Indre og ytre produkter
Ytre produkter og tensor-rang
Laster interaktiv modell / Loading interactive model …
Indreprodukt og ytre produkt går i motsatt retning. Indreproduktet kollapser to vektorer til ett tall. Ytreproduktet bygger ut to vektorer til en matrise - og flere vektorer til en tensor.
Klassisk indreprodukt
For a,b∈Rn er indreproduktet skalaren
⟨a,b⟩=a⊤b=i=1∑naibi.
Se dette i praksis
La
a=123,b=405.
Da er
⟨a,b⟩=1⋅4+2⋅0+3⋅5=19.
Svaret er ett tall, ikke en vektor.
Hurtigsjekk 40. Regn ut indreproduktet mellom
u=2−13,v=14−2,
og oppgi typen til resultatet.
Løsning
Steg 1: Gang samsvarende oppføringer og summer:
⟨u,v⟩=2⋅1+(−1)⋅4+3⋅(−2)=−8.
Steg 2: Resultatet −8 er en skalar.
Klassisk ytre produkt
For u∈Rm og v∈Rn er det ytre produktet matrisen
A=uv⊤∈Rm×n,aij=uivj.
Hver kolonne er en skalert kopi av u, og hver rad er en skalert kopi av v⊤. Et ikke-null ytre produkt av to ikke-null vektorer har matriserang 1.
Se dette i praksis
La
u=(12),v=345.
Da er
uv⊤=(12)(345)=(3648510).
Kolonnene er 3u, 4u og 5u. Radene er v⊤ og 2v⊤. Matrisen har derfor bare én uavhengig rad- og kolonneretning.
Hurtigsjekk 41. La
u=(2−1),v=403.
Regn ut uv⊤, skriv kolonnene som skalerte kopier av u, og bestem matriserangen.
Løsning
Steg 1: Multipliser hver oppføring i u med hele raden v⊤:
uv⊤=(2−1)(403)=(8−4006−3).
Steg 2: Kolonnene er 4u, 0u og 3u.
Steg 3: Begge faktorene er ikke-null, så matrisen har rang 1.
Tensorens ytre produkt
La a(k)∈Rnk for k=1,…,d. Det ytre produktet er tensoren
X=a(1)⊚a(2)⊚⋯⊚a(d)∈Rn1×⋯×nd,
med oppføringer
xi1,…,id=ai1(1)ai2(2)⋯aid(d).
For d=2 er dette det vanlige matriseytreproduktet. For d=3 får vi
X=a⊚b⊚c,xijℓ=aibjcℓ.
Tensor-rang
En ikke-null tensor a(1)⊚⋯⊚a(d) har rang 1 når alle faktorene er ikke-null. Nulltensoren har rang 0.
Tensor-rangen til X er det minste antallet rang-1-tensorer som trengs for å bygge X nøyaktig. Hvis
X=s=1∑rλsas(1)⊚as(2)⊚⋯⊚as(d),
har vi vist at rank(X)≤r. Likhet krever i tillegg at færre ledd er umulig.
Se dette i praksis
La
a=(12),b=(34),c=(56).
Tensoren
X=a⊚b⊚c
har oppføringer xijℓ=aibjcℓ. For eksempel
x2,1,2=a2b1c2=2⋅3⋅6=36.
Alle frontsnittene er skalerte kopier av grunnmatrisen ab⊤:
X::1=5ab⊤,X::2=6ab⊤.
Siden ingen faktor er null, er dette én ikke-null rang-1-tensor.
Hurtigsjekk 42. La
u=(2−1),v=(13),w=(42),Y=u⊚v⊚w.
Finn y2,2,1, de to frontsnittene og tensor-rangen.
Løsning
Steg 1: Den valgte oppføringen er
y2,2,1=u2v2w1=(−1)⋅3⋅4=−12.
Steg 2: Grunnmatrisen er
uv⊤=(2−16−3).
Dermed
Y::1=4uv⊤=(8−424−12),Y::2=2uv⊤=(4−212−6).
Steg 3: Alle tre faktorene er ikke-null, så rank(Y)=1.
Praktisk faktormatrisenotasjon
Samle vektorene i samme modus som kolonner:
A(k)=(a1(k)a2(k)⋯ar(k))∈Rnk×r.
Da kan dekomponeringen skrives
[[λ;A(1),…,A(d)]]:=s=1∑rλsas(1)⊚⋯⊚as(d).
Hvis alle λs=1, utelates vekten. For M∈Rm×n setter den tynne SVD-en q=min{m,n} og bruker Uq∈Rm×q og Vq∈Rn×q. Da passer SVD-en samme mønster:
Her kommer altså alle parene aj⊗bℓ med, ordnet med b-indeksen raskest. Dette er forskjellig fra Khatri–Rao-produktet nedenfor, som bare bruker samsvarende kolonnenumre.
Se dette i praksis
La
A=(1324),B=(0657).
Da er
A⊗B=(1B3B2B4B)=0601857152101202410142028.
For eksempel kommer blokken øverst til høyre fra a12B=2B.
Hurtigsjekk 45. La
C=(12−10),D=(3012).
Regn ut C⊗D og oppgi dimensjonen.
Løsning
Steg 1: Erstatt hvert tall i C med en skalert kopi av D:
C⊗D=(D2D−D0D).
Steg 2: Gang ut blokkene:
C⊗D=30601224−3000−1−200.
Begge faktorene er 2×2, så produktet er 4×4.
Khatri–Rao-produkt
La
A=(a1⋯ar)∈Rm×r,B=(b1⋯br)∈Rp×r
ha samme antall kolonner. Khatri–Rao-produktet defineres kolonnevis:
A⊙B=(a1⊗b1a2⊗b2⋯ar⊗br)∈Rmp×r.
Se dette i praksis
La
A=(1324),B=(5768).
Første resultatkolonne er
a1⊗b1=(13)⊗(57)=571521.
Andre resultatkolonne er
a2⊗b2=(24)⊗(68)=12162432.
Dermed
A⊙B=57152112162432.
Hurtigsjekk 46. Regn ut C⊙D for
C=(12−13),D=(4025).
Løsning
Steg 1: Kombiner første kolonne med første kolonne:
c1⊗d1=(12)⊗(40)=4080.
Steg 2: Kombiner andre kolonne med andre kolonne:
c2⊗d2=(−13)⊗(25)=−2−5615.
Steg 3: Sett kolonnene sammen:
C⊙D=4080−2−5615.
Hadamard-produkt
For matriser A,B∈Rm×n med samme form er Hadamard-produktet elementvis multiplikasjon:
A∗B=(aijbij)∈Rm×n.
Se dette i praksis
La
A=(1324),B=(10302040).
Da er
A∗B=(1⋅103⋅302⋅204⋅40)=(109040160).
Formen er fortsatt 2×2.
Hurtigsjekk 47. Regn ut Hadamard-produktet
(20−13)∗(475−2).
Løsning
Steg 1: Gang oppføringer på samme plass:
(2⋅40⋅7(−1)⋅53⋅(−2))=(80−5−6).
Steg 2: Resultatet har samme dimensjon, 2×2.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 10 · Tensoroperasjoner
Matrisering og k-modusproduktet
Matrisering
Nå kommer vi til delen som virkelig suger, men du må bare komme deg fucking gjennom dette, så blir resten smooth igjen.
Matrisering gjør en tensor om til en matrise uten å endre eller fjerne noen tall. Vi velger én modus som radretning og legger alle fibrene i den modusen som kolonner.
For
X∈Rn1×⋯×nd
har modus-m-matriseringen formen
X(m)∈Rnm×(n1⋯nm−1nm+1⋯nd).
Kurset bruker første indeks først blant de gjenværende modiene.
Jeg vet at dette ser helt jævlig ut, men la meg bryte det ned: den generelle formelen er bare en oppskrift på hvilket kolonnenummer én tensoroppføring får. For oppføringen xi1,…,id er kolonneadressen i X(m)
j=1+k=1k=m∑d(ik−1)jk,jk=ℓ<kℓ=m∏nℓ.
Her er j det nye kolonnenummeret, mens jk er spranglengden til indeks ik. Et tomt produkt er 1.
Med andre ord: fjern radindeksen im. La den første gjenværende indeksen variere raskest. Tell deretter videre modus for modus.
For X∈Rm×n×p gir oppskriften de tre konkrete tilfellene
En matrise av orden 2 er blitt en vektor av orden 1.
Hurtigsjekk 50. For
D=(2−113),v=(24),w=(3−1),
finn D×1v og D×2w.
Løsning
Steg 1: Kontraksjon i første modus gir
D⊤v=(21−13)(24)=(014).
Steg 2: Kontraksjon i andre modus gir
Dw=(2−113)(3−1)=(5−6).
Khatri–Rao-produkt og matrisering
Hvis
X=[[A,B,C]]∈Rm×n×p,
er de tre viktige identitetene
X(1)=A(C⊙B)⊤,X(2)=B(C⊙A)⊤,X(3)=C(B⊙A)⊤.
Rekkefølgen følger kursets første-indeks-først-konvensjon. For ett rang-1-ledd blir for eksempel kolonnen med de andre faktorene c⊗b, ikke b⊗c.
Se dette i praksis
La
A=(1324),B=(1001),C=(2113).
De samsvarende Kronecker-kolonnene er
c1⊗b1=2010,c2⊗b2=0103.
Derfor
C⊙B=20100103.
Nå blir tensoruttrykket en vanlig matriseproduktberegning:
X(1)=A(C⊙B)⊤=(262413612).
Hurtigsjekk 51. La
A=(1201),B=(1001),C=(1321).
Finn C⊙B og deretter X(1)=A(C⊙B)⊤.
Løsning
Steg 1: Beregn de samsvarende Kronecker-kolonnene:
c1⊗b1=1030,c2⊗b2=0201.
Dermed
C⊙B=10300201.
Steg 2: Multipliser:
X(1)=(1201)(10023001)=(12023601).
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 11 · Tensordekomponering: CP og ALS
CP-dekomponering og ALS
Laster interaktiv modell / Loading interactive model …
CP står for Canonical Polyadic og er selve dekomponeringsmodellen. ALS står for Alternating Least Squares og er algoritmen vi bruker for å tilpasse modellen til dataene.
Motivasjon fra SVD
For M∈Rm×n setter vi q=min{m,n} og bruker de tynne SVD-faktorene Uq∈Rm×q og Vq∈Rn×q. Da skriver SVD matrisen som en sum av rang-1-matriser:
M=UqΣqVq⊤=s=1∑qσsusvs⊤=[[σ;Uq,Vq]].
Tensoranalogen spør om en komplisert tensor kan bygges eller tilnærmes med noen få enkle ytre-produkt-blokker:
X≈s=1∑ras⊚bs⊚cs=[[A,B,C]].
Flere blokker gir vanligvis en bedre tilnærming, men hver enkelt blokk er fortsatt rang 1.
Se dette i praksis
Ta to rang-1-ledd:
a1=(12),b1=(10),c1=(13),
og
a2=(01),b2=(21),c2=(11).
Det første leddet har grunnmatrise
a1b1⊤=(1200)
og frontsnitt
X::1(1)=(1200),X::2(1)=(3600).
Det andre leddet har grunnmatrise
a2b2⊤=(0201)
og samme bidrag i begge lag. Når leddene legges sammen, blir
X::1≈(1401),X::2≈(3801).
Et rikere mønster er blitt bygget av to enkle blokker.
Finn de to frontsnittene til summen av de to rang-1-leddene.
Løsning
Steg 1: Grunnmatrisene er
a1b1⊤=(2200),a2b2⊤=(001−1).
Steg 2: Første lag bruker vektene 1 og 3:
X::1=a1b1⊤+3a2b2⊤=(223−3).
Steg 3: Andre lag bruker vektene 2 og 1:
X::2=2a1b1⊤+a2b2⊤=(441−1).
Canonical Polyadic-dekomponering
Tensorens Frobenius-norm er
∥X∥F=i=1∑mj=1∑nℓ=1∑pxijℓ2.
Canonical Polyadic forkortes CP. Navnene CANDECOMP og PARAFAC brukes også. Et eksplisitt vekttall λs kan absorberes i én av faktorvektorene.
Se dette i praksis
La en tensor ha snittene
X::1=(1001),X::2=(2002).
En rang-1-modell
Y=a⊚b⊚c
må ha snitt som skalerte kopier av den samme rang-1-matrisen ab⊤. Velger vi
a=b=(10),c=(12),
får vi
Y::1=(1000),Y::2=(2000).
Den øvre venstre strukturen treffes, men den nedre høyre mangler. Legger vi til
(01)⊚(01)⊚(12),
rekonstrueres begge snittene nøyaktig med to rang-1-ledd.
Hurtigsjekk 53. En tensor har snittene
Z::1=(2003),Z::2=(−1006).
Finn en eksakt CP-dekomponering med to ledd, og forklar hvorfor ett ledd ikke er nok.
Løsning
Steg 1: Del de to diagonalretningene:
Z=e1⊚e1⊚(2−1)+e2⊚e2⊚(36).
Dette gir nøyaktig de oppgitte diagonalene i begge lag.
Steg 2: Allerede Z::1 har matriserang 2. Et enkelt tensorytreprodukt ville gitt et snitt som er en skalert rang-1-matrise. Ett ledd er derfor umulig, og CP-rangen er 2.
Beregning av CP-dekomponering med alternerende minste kvadrater
Direkte minimering er vanskelig fordi A, B og C påvirker hverandre. Alternating Least Squares (ALS) fryser to faktormatriser og oppdaterer den tredje.
Ikke la de tre linjene nedenfor skremme deg: hver linje er bare et vanlig minste-kvadraters problem der to faktorer holdes fast og én får bevege seg.
Fra matriseringene får vi tre vanlige minste-kvadraters problemer:
Her er hevet + bare en merkelapp for den nyoppdaterte faktoren. Moore–Penrose-pseudoinversen som brukes i løsningene nedenfor, skrives †.
Oppdater A. Hold B og C fast, og la bare A bevege seg:
A+=argAmin∥X(1)−A(C⊙B)⊤∥F2,
Oppdater B. Bruk den nye A+, hold C fast, og la B bevege seg:
B+=argBmin∥X(2)−B(C⊙A+)⊤∥F2,
Oppdater C. Bruk de nye A+ og B+, og la til slutt C bevege seg:
Deretter bygges X(k+1) og for eksempel den relative feilen
ρk+1=∥X∥F∥X−X(k+1)∥F
kontrolleres. Stopp når feilen er liten nok, nesten ikke endres, eller et maksimalt antall iterasjoner er nådd.
Se dette i praksis
Velg en CP-modell med r=2 ledd. Da har faktorene form
A∈Rm×2,B∈Rn×2,C∈Rp×2.
Én iterasjon ser slik ut:
Start med A(0),B(0),C(0).
Frys B(0) og C(0), og finn en bedre A(1).
Bruk den nye A(1), frys den og C(0), og finn B(1).
Bruk både A(1) og B(1), og finn C(1).
Bruk A(1),B(1),C(1) som start for neste runde.
Tallet i parentes er iterasjonsnummeret; det er ikke en potens.
Hurtigsjekk 55. For X∈R4×3×2 brukes en CP-modell med r=2 ledd. Oppgi dimensjonene til A,B,C, og fortell hvilke gamle eller nye faktorer som brukes i hver av de tre oppdateringene fra iterasjon k til k+1.
Løsning
Steg 1: Faktordimensjonene er
A:4×2,B:3×2,C:2×2.
Steg 2:A(k+1) bruker gamle B(k) og C(k).
Steg 3:B(k+1) bruker nye A(k+1) og gamle C(k).
Steg 4:C(k+1) bruker både nye A(k+1) og nye B(k+1). Først da er én hel ALS-syklus ferdig.
Skalaene ganger seg til 1, så rekonstruksjonen er nøyaktig. Siden
∥X∥F=22+62+42+122+(−1)2+(−3)2+(−2)2+(−6)2=250,
blir den eksplisitte kontrollen
ρ1=2500=0.
I generelle data må syklusen gjentas.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Del 12 · Tucker-dekomponering, HOSVD og HOOI
Tucker, HOSVD og HOOI
Laster interaktiv modell / Loading interactive model …
Motivasjon fra SVD og modusprodukter
Tucker ser først ut som CP med altfor mange bevegelige deler, men hovedideen er enkel: en liten kjerne forteller hvilke retninger som får lov til å blandes.
SVD kan skrives med modusprodukter:
M=UΣV⊤=Σ×1U×2V.
Her er Σ en liten, diagonal kjerne, mens U og V utvider kjernen i hver sin retning. For en tredjeordens tensor bruker Tucker samme idé med en kjerne og tre faktormatriser:
G∈Rr1×r2×r3,A∈Rm×r1,B∈Rn×r2,C∈Rp×r3,
og
Y=G×1A×2B×3C.
Utvidet som ytre produkter er dette
Y=α=1∑r1β=1∑r2γ=1∑r3gαβγaα⊚bβ⊚cγ.
Hvis r1=r2=r3=r og kjernen er superdiagonal,
gαβγ={λα,0,α=β=γ,ellers,
står bare samsvarende tripler igjen. Da er CP et spesialtilfelle av Tucker.
Se dette i praksis
I en CP-modell med to ledd får vi bare de samsvarende triplene
a1⊚b1⊚c1+a2⊚b2⊚c2.
En Tucker-kjerne kan også blande forskjellige kolonnenumre. La
G∈R2×2×2
ha bare to ikke-null oppføringer:
g1,1,1=5,g2,1,2=3.
Da er
Y=5a1⊚b1⊚c1+3a2⊚b1⊚c2.
Det andre leddet kobler retning 2 fra A, retning 1 fra B og retning 2 fra C. Kjernen tillater altså krysskoblinger som en superdiagonal CP-kjerne ikke tillater.
Hurtigsjekk 56. En 2×2×2-kjerne har bare g1,2,1=−2 og g2,1,2=4 som ikke-null oppføringer. Skriv Tucker-modellen som en sum av to ytre produkter, og forklar hvorfor dette ikke er en CP-kjerne i den oppgitte basisen.
Løsning
Steg 1: Hver ikke-null kjerneoppføring velger én kolonne fra hver faktor:
Y=−2a1⊚b2⊚c1+4a2⊚b1⊚c2.
Steg 2: En CP-kjerne er superdiagonal og kobler bare (1,1,1), (2,2,2) og så videre. Her brukes (1,2,1) og (2,1,2), så kjernen har krysskoblinger.
Definisjon av Tucker-dekomponering
Se dette i praksis
Anta at den opprinnelige tensoren er
X∈R100×80×50,
og velg Tucker-størrelser
r1=5,r2=4,r3=3.
Da har kjernen og faktorene dimensjonene
G∈R5×4×3,A∈R100×5,B∈R80×4,C∈R50×3.
Modellen
X≈G×1A×2B×3C
lagrer en liten kjerne og tre smale faktormatriser. Den fulle tensoren krever
100⋅80⋅50=400000
tall. Tucker-formen krever
5⋅4⋅3+100⋅5+80⋅4+50⋅3=60+500+320+150=1030
tall. Her er det nettopp den lille kjernen og de smale faktorene som gir komprimeringen.
Hurtigsjekk 57. For X∈R20×15×10 brukes Tucker-størrelser (4,3,2). Oppgi dimensjonene til G,A,B,C, og sammenlign antall lagrede tall i full tensor og Tucker-formen.
Tucker bruker Kronecker-produktet fordi kjernen kan koble alle kombinasjoner av faktorretninger. CP bruker Khatri–Rao fordi bare samsvarende kolonner kobles.
I den første formelen bygger A ut modus 1, G(1) inneholder blandingen fra kjernen, og C⊗B lister alle kombinasjoner fra modus 3 og 2. De to andre formlene er den samme ideen sett fra en annen modus.
SVD-analogien virker også baklengs:
M=UΣV⊤⟹Σ=U⊤MV=M×1U⊤×2V⊤.
Tilsvarende komprimeres Tucker-kjernen med
G=X×1A⊤×2B⊤×3C⊤
når faktorene har ortonormale kolonner.
Se dette i praksis
Se på modus-1-formelen
Y(1)=AG(1)(C⊗B)⊤.
Anta
A∈R4×2,G(1)∈R2×6,C⊗B∈R15×6.
Da er
(C⊗B)⊤∈R6×15,
og dimensjonskjeden blir
(4×2)(2×6)(6×15)=4×15.
Dermed er Y(1)∈R4×15, som betyr at den rekonstruerte tensoren har modus-1-størrelse 4 og de to andre størrelsene ganger seg til 15.
Hurtigsjekk 58. La
A:5×2,B:4×3,C:6×2,G:2×3×2.
Finn dimensjonene til G(1), C⊗B, (C⊗B)⊤ og Y(1).
Løsning
Steg 1: Modus-1-matriseringen av kjernen har
G(1):2×(3⋅2)=2×6.
Steg 2: Kronecker-produktet har
C⊗B:(6⋅4)×(2⋅3)=24×6,
så transponeringen er 6×24.
Steg 3: Dimensjonskjeden er
(5×2)(2×6)(6×24)=5×24.
Altså er Y(1):5×24, som passer en tensor av form 5×4×6.
Regn ut en liten Tucker-modell med tall
Vi rekonstruerer en 2×2×2-tensor med multirang høyst (2,2,1). Velg
G::1=(1012),A=(1011),B=(1101),C=(12).
Fordi tredje kjernemodus har størrelse 1, lager vi først grunnmatrisen
Tallene i C skalerer denne matrisen i de to lagene:
Y::1=H=(1042),Y::2=2H=(2084).
De ikke-null kjerneoppføringene gir også
Y=a1⊚b1⊚c1+a1⊚b2⊚c1+2a2⊚b2⊚c1.
Midterleddet er en Tucker-krysskobling mellom a1 og b2.
Higher-Order Singular Value Decomposition
Navnet HOSVD er mye verre enn selve oppskriften: matrisér i hver retning, kjør den SVD-en du allerede kjenner, og behold de viktigste kolonnene.
HOSVD finner en Tucker-type modell ved å bruke SVD på hver matrisering. Med ønskede størrelser (r1,r2,r3) er dette en trunkert HOSVD:
La A være de r1 ledende venstre singulærvektorene til X(1).
La B være de r2 ledende venstre singulærvektorene til X(2).
La C være de r3 ledende venstre singulærvektorene til X(3).
Beregn kjernen
G=X×1A⊤×2B⊤×3C⊤.
Returner G,A,B,C og eventuelt
X=G×1A×2B×3C.
Se dette i praksis
La
X∈R6×5×4
og velg Tucker-størrelser
(r1,r2,r3)=(2,2,1).
HOSVD utfører tre SVD-er:
Ta SVD av X(1)∈R6×20 og behold to venstre singulærvektorer.
Ta SVD av X(2)∈R5×24 og behold to.
Ta SVD av X(3)∈R4×30 og behold én.
Dermed får vi
A∈R6×2,B∈R5×2,C∈R4×1,
og
G=X×1A⊤×2B⊤×3C⊤∈R2×2×1.
HOSVD har valgt de viktigste retningene separat i hver modus.
Hurtigsjekk 59. La Y∈R8×6×5 og velg størrelser (3,2,2). Oppgi dimensjonene til de tre matriseringene, hvilke singulærvektorer som beholdes, og dimensjonene til A,B,C,G.
og velg (r1,r2,r3)=(1,1,1). De eneste ikke-null oppføringene er x111=3 og x222=1.
Med kursets kolonnerekkefølge er de tre matriseringene i dette symmetriske eksemplet identiske:
X(1)=X(2)=X(3)=(30000001).
Singulærverdiene er 3 og 1, og den ledende venstre singulærvektoren er
e1=(10).
Dermed
A=B=C=e1.
Kjernen er ett tall:
G=X×1e1⊤×2e1⊤×3e1⊤=[3].
Rekonstruksjonen
X=3e1⊚e1⊚e1
beholder x111=3 og kaster x222=1. Derfor
∥X−X∥F=1,∥X∥F∥X−X∥F=101.
Higher-Order Orthogonal Iteration
HOOI bruker HOSVD som start og forbedrer én faktormatrise om gangen:
Initialiser A,B,C med HOSVD.
Gjenta:
ZA=X×2B⊤×3C⊤,
og la A være de r1 ledende venstre singulærvektorene til (ZA)(1).
Deretter
ZB=X×1A⊤×3C⊤,
og la B være de r2 ledende venstre singulærvektorene til (ZB)(2).
Til slutt
ZC=X×1A⊤×2B⊤,
og la C være de r3 ledende venstre singulærvektorene til (ZC)(3).
Sett A=A, B=B, C=C, og stopp når feilen eller faktorene nesten ikke endrer seg. Beregn så
G=X×1A⊤×2B⊤×3C⊤.
Se dette i praksis
Anta at HOSVD har gitt startmatrisene
A(0),B(0),C(0).
Én HOOI-sveip oppdaterer dem i denne rekkefølgen:
Komprimer X med B(0) og C(0). SVD-en av modus-1-matriseringen gir A(1).
Komprimer med den nye A(1) og gamle C(0). SVD-en i modus 2 gir B(1).
Komprimer med nye A(1) og B(1). SVD-en i modus 3 gir C(1).
Neste sveip starter med A(1),B(1),C(1). HOOI er altså HOSVD-idéen gjentatt, med ny informasjon fra de andre modiene hver gang.
Hurtigsjekk 60. La X∈R6×5×4 og (r1,r2,r3)=(2,2,1). Finn formene til ZA, ZB og ZC i én HOOI-sveip, og oppgi hvilke faktorer som er nye eller gamle i hvert steg.
Løsning
Steg 1: Med B⊤:2×5 og C⊤:1×4 får vi
ZA=X×2B⊤×3C⊤∈R6×2×1.
Her brukes gamle B og C, og resultatet gir nye A.
Steg 2: Bruk nye A⊤:2×6 og gamle C⊤:1×4:
ZB∈R2×5×1.
Dette gir nye B.
Steg 3: Bruk både nye A⊤ og nye B⊤:
ZC∈R2×2×4.
Modus-3-matriseringen har form 4×4, og dens ledende venstre singulærvektor gir nye C.
Bonus/utsyn: én numerisk HOOI-sveip
Bruk HOSVD-eksemplet over med (r1,r2,r3)=(1,1,1) og start
A=B=C=e1.
Første projeksjon er
ZA=X×2e1⊤×3e1⊤=(30).
Den ledende venstre singulærvektoren er fortsatt e1, så A=e1. På samme måte får vi
ZB=(30)⟹B=e1,ZC=(30)⟹C=e1.
Kjernen er fortsatt [3], og feilen er fortsatt 1. Eksemplet er med vilje stasjonært: HOSVD-starten var allerede et fast punkt. På generelle data endres retningene. Eksakte blokkoppdateringer skal ikke forverre tilpasningen, men HOOI garanterer ikke et globalt minimum.
Oppsummering
Tensorer generaliserer skalarer, vektorer og matriser til flere modi.
Fibre oppstår når alle unntatt én indeks festes; snitt oppstår når én indeks festes.
Ytre produkter lager rang-1-tensorer, og tensor-rang er det minste antallet slike byggeklosser i en eksakt sum.
Vektorisering, Kronecker, Khatri–Rao og Hadamard er forskjellige operasjoner med forskjellige dimensjonskrav.
Matrisering flytter tall til en matrise, mens et k-modusprodukt transformerer én retning og oppfyller Y(k)=QX(k).
CP bruker samsvarende faktortripler; ALS finner faktorene ved vekslende minste-kvadraters problemer.
Tucker bruker en liten kjerne og én faktormatrise per modus.
HOSVD gir en Tucker-start fra SVD-er av matriseringene; HOOI forbedrer faktorene iterativt.
Din vurderingHva vil du ta med videre?
Hvordan kjentes denne delen?
Sjekker lokal lagring …
Se det før du regner
SVD er en maskin med tre steg
Ax = U(Σ(Vᵀx))
Én vanskelig transformasjon blir: rett inn retningene → strekk eller klem → plasser resultatet.
x
Start med en vektor x. En matrise kan endre både retningen og lengden.
Vᵀ · retningerΣ · styrkeU · plassering
Interaktiv utregningVelg matrisetilfellet
A† = A⁻¹
Rangkontrollen velger formelen. Bruk deretter steg 1–4 for å følge ett talleksempel helt frem til kontroll og tolkning.
det(A) = 2 · 1 − 1 · 1 = 1 ≠ 0Dermed finnes den vanlige inversen.
Start med et fargebilde
Hva er en tensor?
𝓧 ∈ ℝ³ˣ⁴ˣ³
I numerisk matematikk er en tensor en flerveis tabell med tall. Et fargebilde er et konkret eksempel: én talltabell per fargekanal.
Orden forteller hvor mange koordinater en adresse trengerDet forteller ikke hvor mange tall som er lagret.
Skalarorden 0ett tall
Vektororden 1én indeks i
Matriseorden 2rad i, kolonne j
3-tensororden 3rad i, kolonne j, lag ℓ
: Kolonet betyr «denne indeksen får variere». En fiber har ett kolon; et snitt har to.
Adresse
Fiber · én indeks varierer
Snitt · én indeks er fast
ℓ = 1 · rød (R)
852739461752
i ↓j →
ℓ = 2 · grønn (G)
274183659247
i ↓j →
ℓ = 3 · blå (B)
518462735916
i ↓j →
𝓧 ∈ ℝ³ˣ⁴ˣ³
Dette er én 3 × 4 × 3-tensor: tre talltabeller som holdes samlet. De tre indeksretningene er rad i, kolonne j og fargelag ℓ.
0 frie → verdi1 fri → fiber2 frie → snitt
Bygg en tensor av tre vektorer
Ett mønster, skalert gjennom snittene
𝓧 = a ∘ b ∘ c
Bruk a = (1, 2), b = (1, −1, 2) og c = (2, −1, 3). Først lager a og b 2 × 3-mønsteret abᵀ. Hver verdi i c, med indeks ℓ, skalerer bare det samme mønsteret.
a
12
∘
b
1-12
→
abᵀ
1-122-24
×
c
2-13
2-244-48
-11-2-22-4
3-366-612
X::1 = 2abᵀ
Snitt 1 ganger hver rute i grunnmønsteret med 2. Plasseringene og de proporsjonale radene er de samme; bare størrelsen og, når den valgte c-verdien er negativ, fortegnene endres.
Samme input, tre ulike regler
Ikke kjenn igjen et produkt bare på symbolet
A, B ∈ ℝ²ˣ²
Hold A = [[1, 2], [3, 4]] og B = [[2, −1], [0, 3]] faste. Bytt bare regel og se hvordan outputformen endres.
A
1234
∗
B
2-103
=
A ∗ B
2-2012
Samme plass møter samme plass
A og B må ha nøyaktig samme form. Gang aᵢⱼ med bᵢⱼ, rute for rute. For eksempel blir 2 · (−1) = −2 øverst til høyre.
Tenk på A, B og C som ordbøker: hver kolonne er et gjenbrukbart retningsmønster. Den lille kjernen G lagrer hvilke mønsterkombinasjoner som betyr noe, og hvor sterkt de skal blandes.
Hele datasettet
X · 4 × 3 × 3
≈
Kombinasjonstabell
G · 2 × 2 × 2
→
×1 A
a1a2
A ∈ ℝ4×2
→
×2 B
b1b2
B ∈ ℝ3×2
→
×3 C
c1c2
C ∈ ℝ3×2
→
Rekonstruksjon
X̂ · 4 × 3 × 3
Form etter dette steget2 × 2 × 2
G ∈ ℝ²ˣ²ˣ²
Start med den lille 2 × 2 × 2-kjernen. Den er en kombinasjonstabell, ikke et miniatyrbilde: g[p,q,r] sier hvor sterkt retning p fra A, retning q fra B og retning r fra C skal virke sammen.
Algoritmevisualisering
Slik finner høyereordens singularverdidekomponering A, B, C og G
Matrisér → SVD → behold retninger → komprimer
X · 4 × 3 × 3
matrisér →
X(1) · 4 × 9
SVD →
×1 A
a1a2
A ∈ ℝ4×2
X(1) ∈ ℝ4×9 → A ∈ ℝ4×2
Legg alle modus-1-fibrene som kolonner i modus-1-matriseringen. Beregn singularverdidekomponeringen og behold de to ledende venstre singularvektorene. De blir de to kolonnene i A.